数据工程新手项目 - 云服务 Astro、Databricks、S3
使用 Astro 托管的 Airflow、Databricks 与 Amazon S3 搭建云端数据工程练习环境,记录配置步骤、数据处理流程与问题排查。
为了进一步了解国外基于云的数据平台、数据分析平台的解决方案,找了一个项目进行练习。
01 介绍
Astro 是由 Astronomer 公司推出的一个基于云的数据平台,专注于构建、运行和管理基于 Apache Airflow 的数据工作流。
Databricks 是一个基于云的大数据处理和分析平台,广泛应用于大数据分析、机器学习和 AI 场景。
S3 是 AWS 上的对象存储服务。
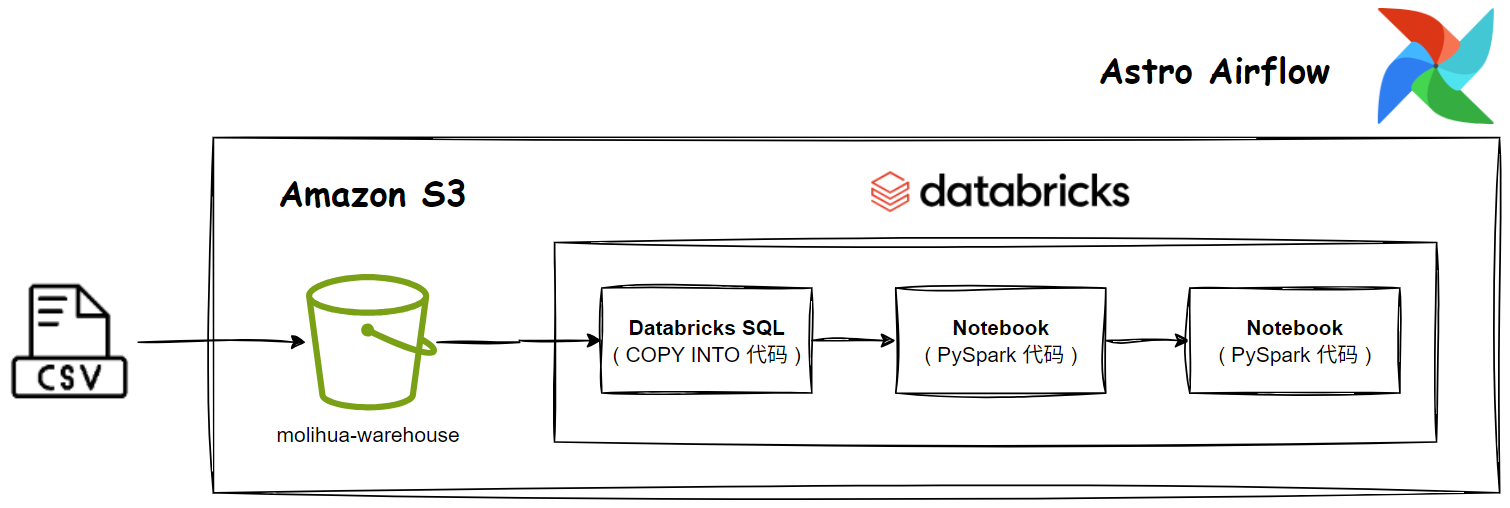
这个练习项目使用 Astro 托管的 Airflow 来进行任务编排 ( Airflow 的版本为 v3.0.0 ),使用 Databricks 来进行数据集成和数据处理、数据分析,S3 作为数据源。
注:Databricks、AWS 上都有完整的数据平台、数据分析平台的解决方案。
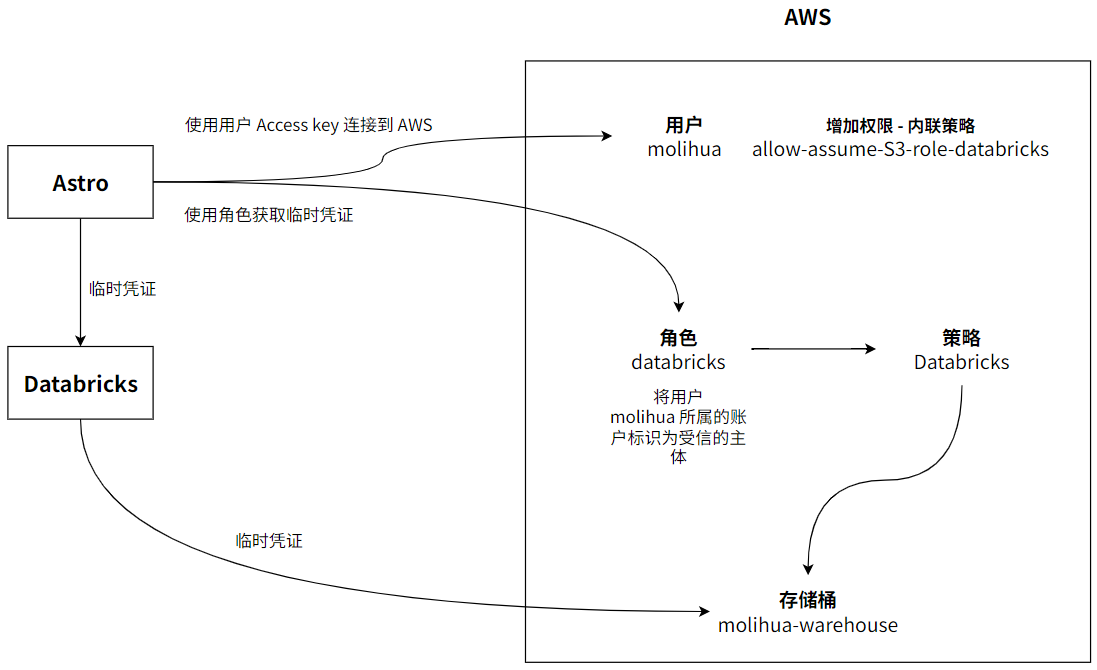
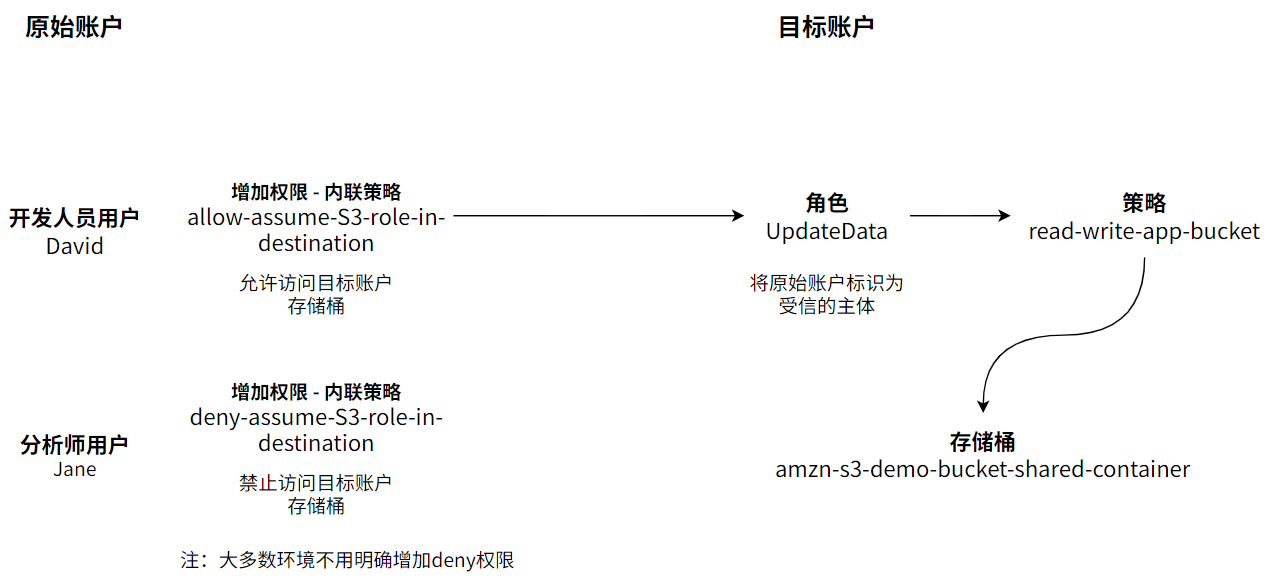
要了解使用临时凭证的方案访问 S3,可以先阅读“IAM 教程:使用 IAM 角色委托跨 AWS 账户的访问权限”
02 架构
1. 整体的架构及数据流图
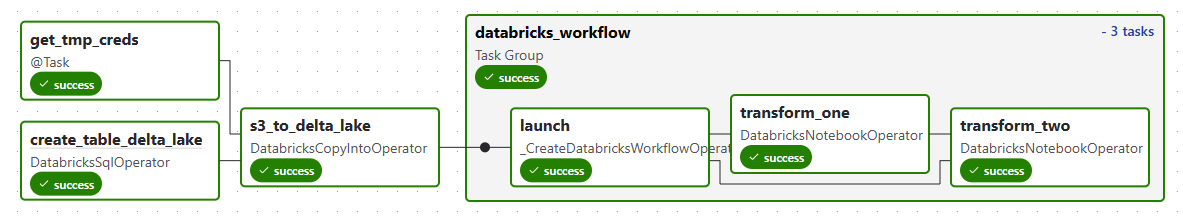
2. Airflow DAG 执行示例
3. Astro、Databricks 访问 AWS 的权限配置示意图
03 操作步骤
1. Amazon S3 准备
(1)注册 AWS 账户
支持国内信用卡,试用过程中要多关注账单。
(2)创建存储桶
导航到 Amazon S3,选择 “General purpose buckets” 创建存储桶,默认设置即可。
存储桶: molihua-warehouse
(3)创建 IAM 用户 和 AWS Access key
- 创建 IAM 用户
导航到 IAM,创建 IAM 用户,为用户配置"AmazonS3FullAccess"的权限策略或是配置访问指定存储桶的权限策略。
用户: molihua
为 IAM 用户配置访问指定存储桶权限策略
{
    "Version": "2012-10-17",
    "Statement": [
      {
        "Effect": "Allow",
        "Action": "s3:ListAllMyBuckets",
        "Resource": "*"
      },
      {
        "Effect": "Allow",
        "Action": [
          "s3:ListBucket"
        ],
        "Resource": [
          "arn:aws:s3:::molihua-warehouse"
        ]
      },
      {
        "Effect": "Allow",
        "Action": [
          "s3:PutObject",
          "s3:GetObject",
          "s3:DeleteObject",
          "s3:PutObjectAcl"
        ],
        "Resource": [
          "arn:aws:s3:::molihua-warehouse/*"
        ]
      }
    ]
  }
其中 “ListAllMyBuckets” 是为了在 AWS CLI 能够获取存储桶列表
- 创建 AWS Access key
在 IAM 用户的界面为创建的用户创建 Access key,“Use case” 选择 “Local code” 就可以。
# Airflow 连接 AWS 会用到
aws_access_key_id: YOUR_AWS_ACCESS_KEY_ID
aws_secret_access_key: YOUR_AWS_SECRET_ACCESS_KEY
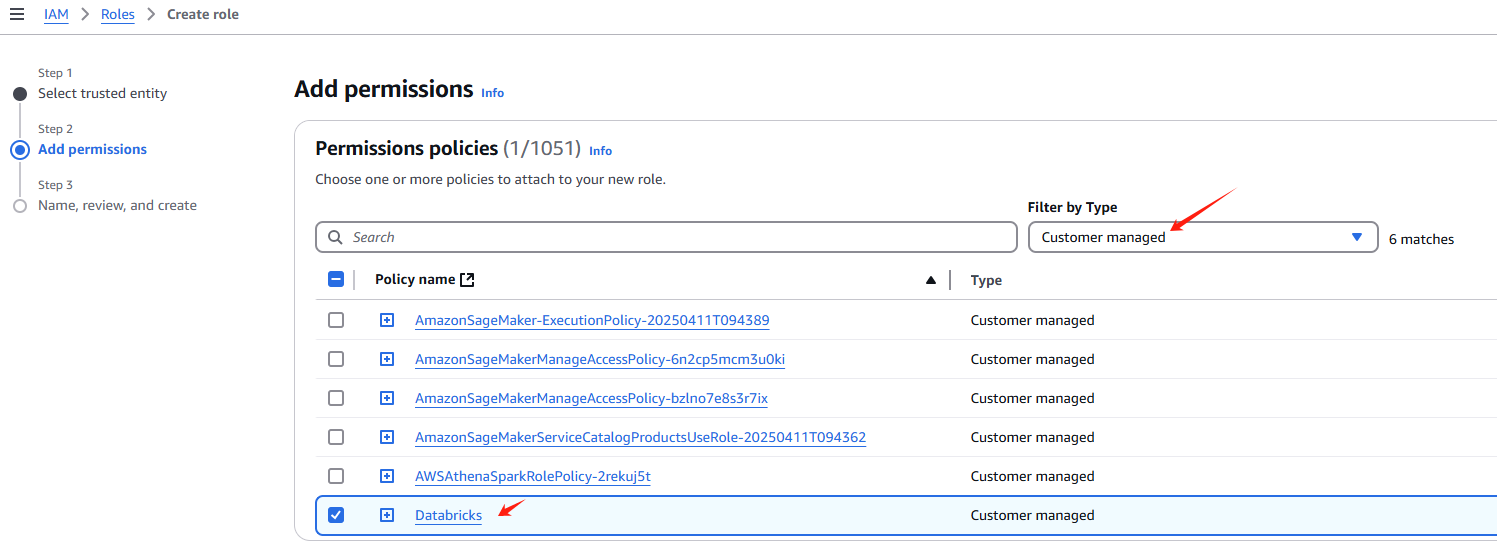
(4)创建 IAM 角色、策略
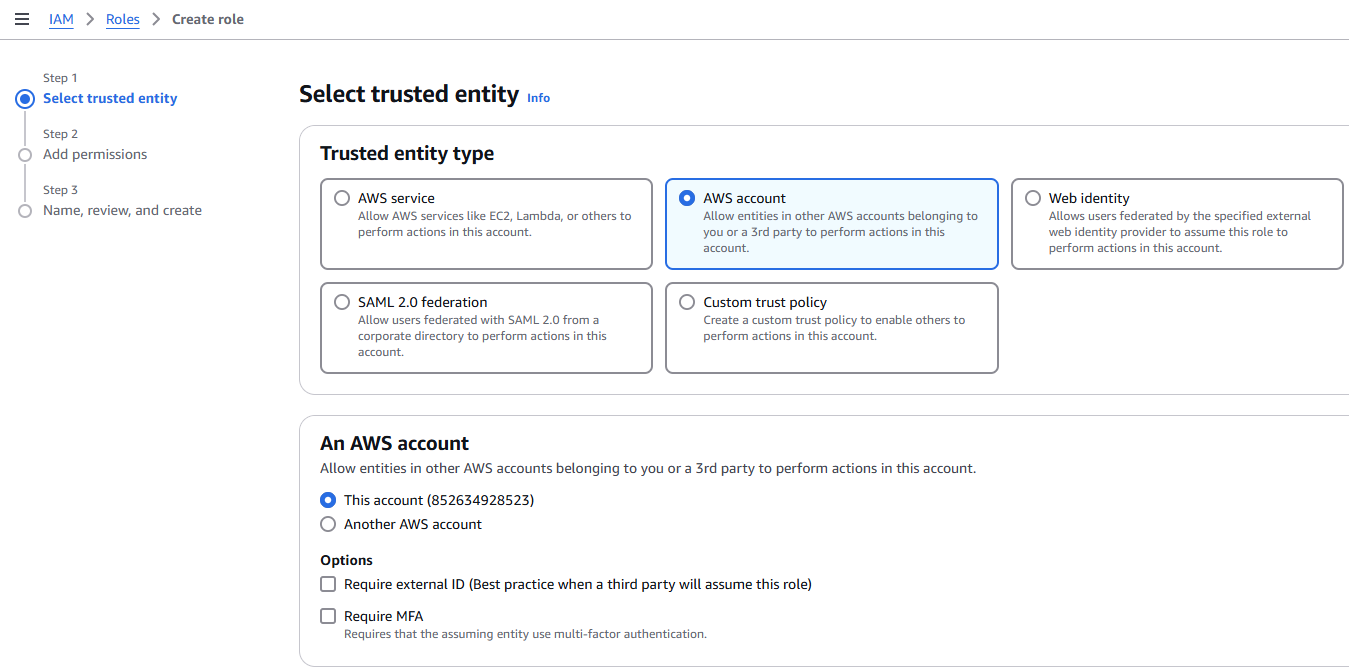
专门为 Databricks 访问指定 S3 存储桶而创建的角色。
- 创建策略
策略名称: Databricks
{
    "Version": "2012-10-17",
    "Statement": [
      {
        "Effect": "Allow",
        "Action": [
          "s3:ListBucket"
        ],
        "Resource": [
          "arn:aws:s3:::molihua-warehouse"
        ]
      },
      {
        "Effect": "Allow",
        "Action": [
          "s3:PutObject",
          "s3:GetObject",
          "s3:DeleteObject",
          "s3:PutObjectAcl"
        ],
        "Resource": [
          "arn:aws:s3:::molihua-warehouse/*"
        ]
      }
    ]
  }
- 创建角色
角色名称: databricks
- 查看角色的 ARN
# Airflow 连接 AWS 会用到
ARN: arn:aws:iam::852634928523:role/databricks
2. Astro 准备
(1)注册账户
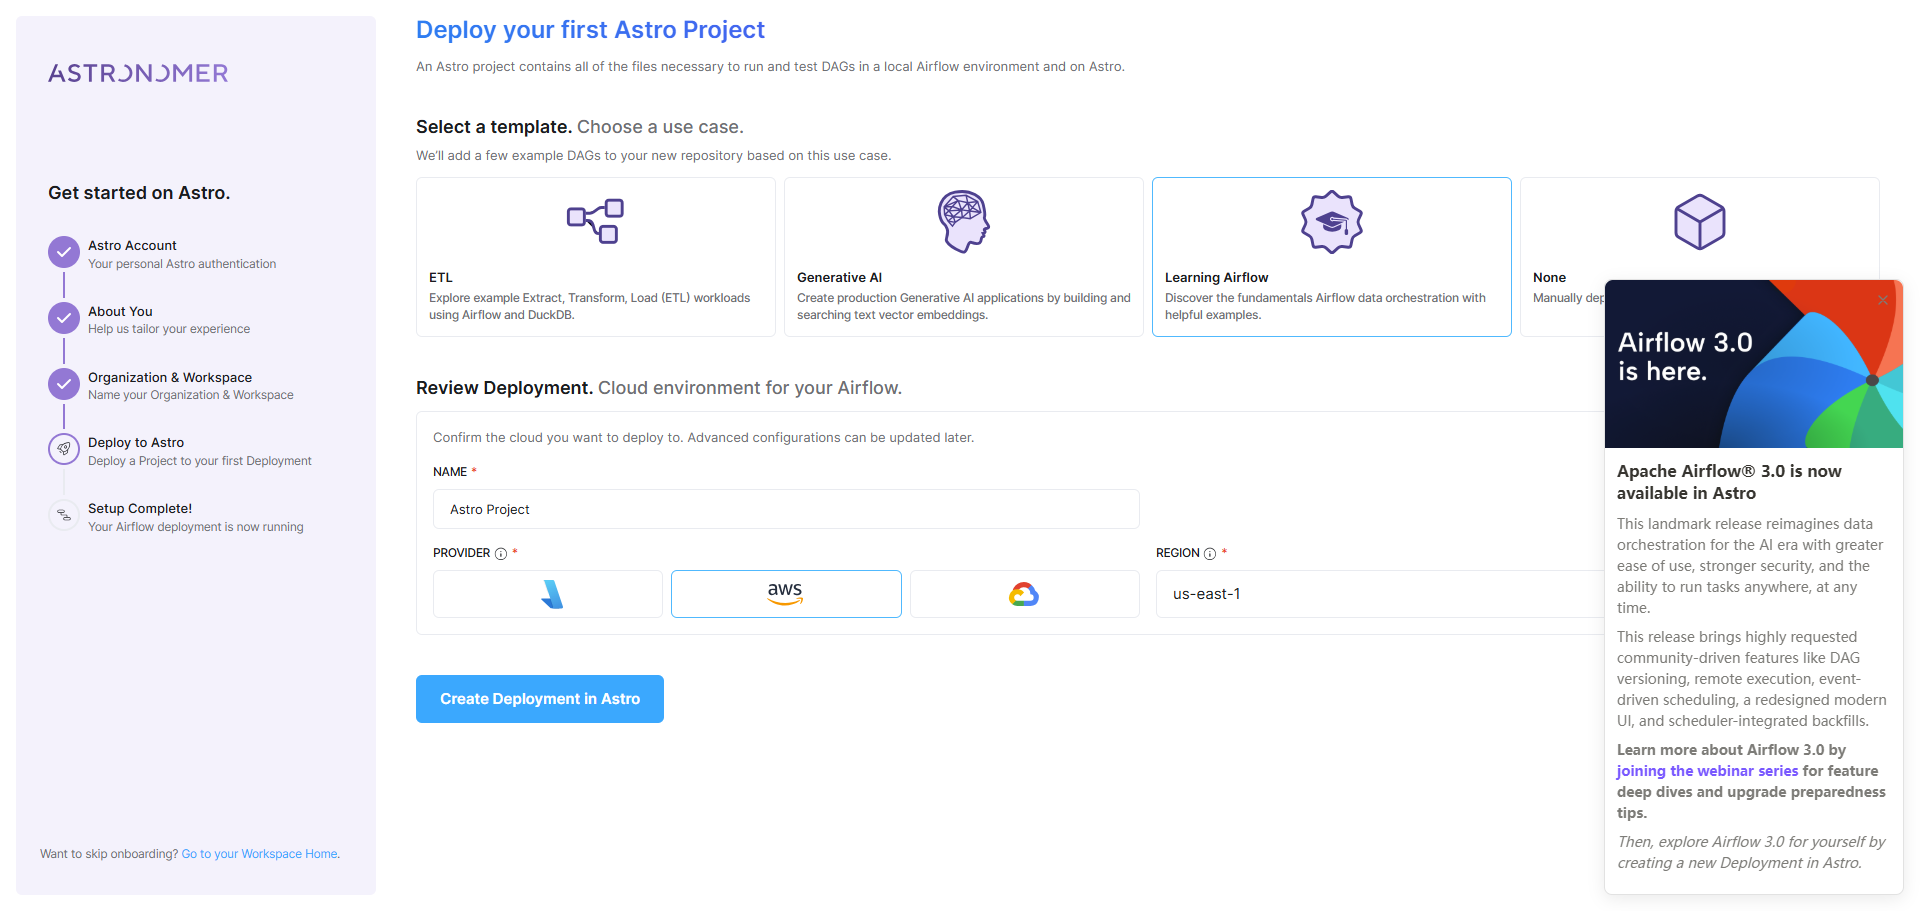
(2)创建 Deployment
在" Deploy to Astro" 环节,template 选择"ETL"、“Learning Airflow” 都可以,云平台按需选择即可。
3. Databricks 准备
(1)注册账户
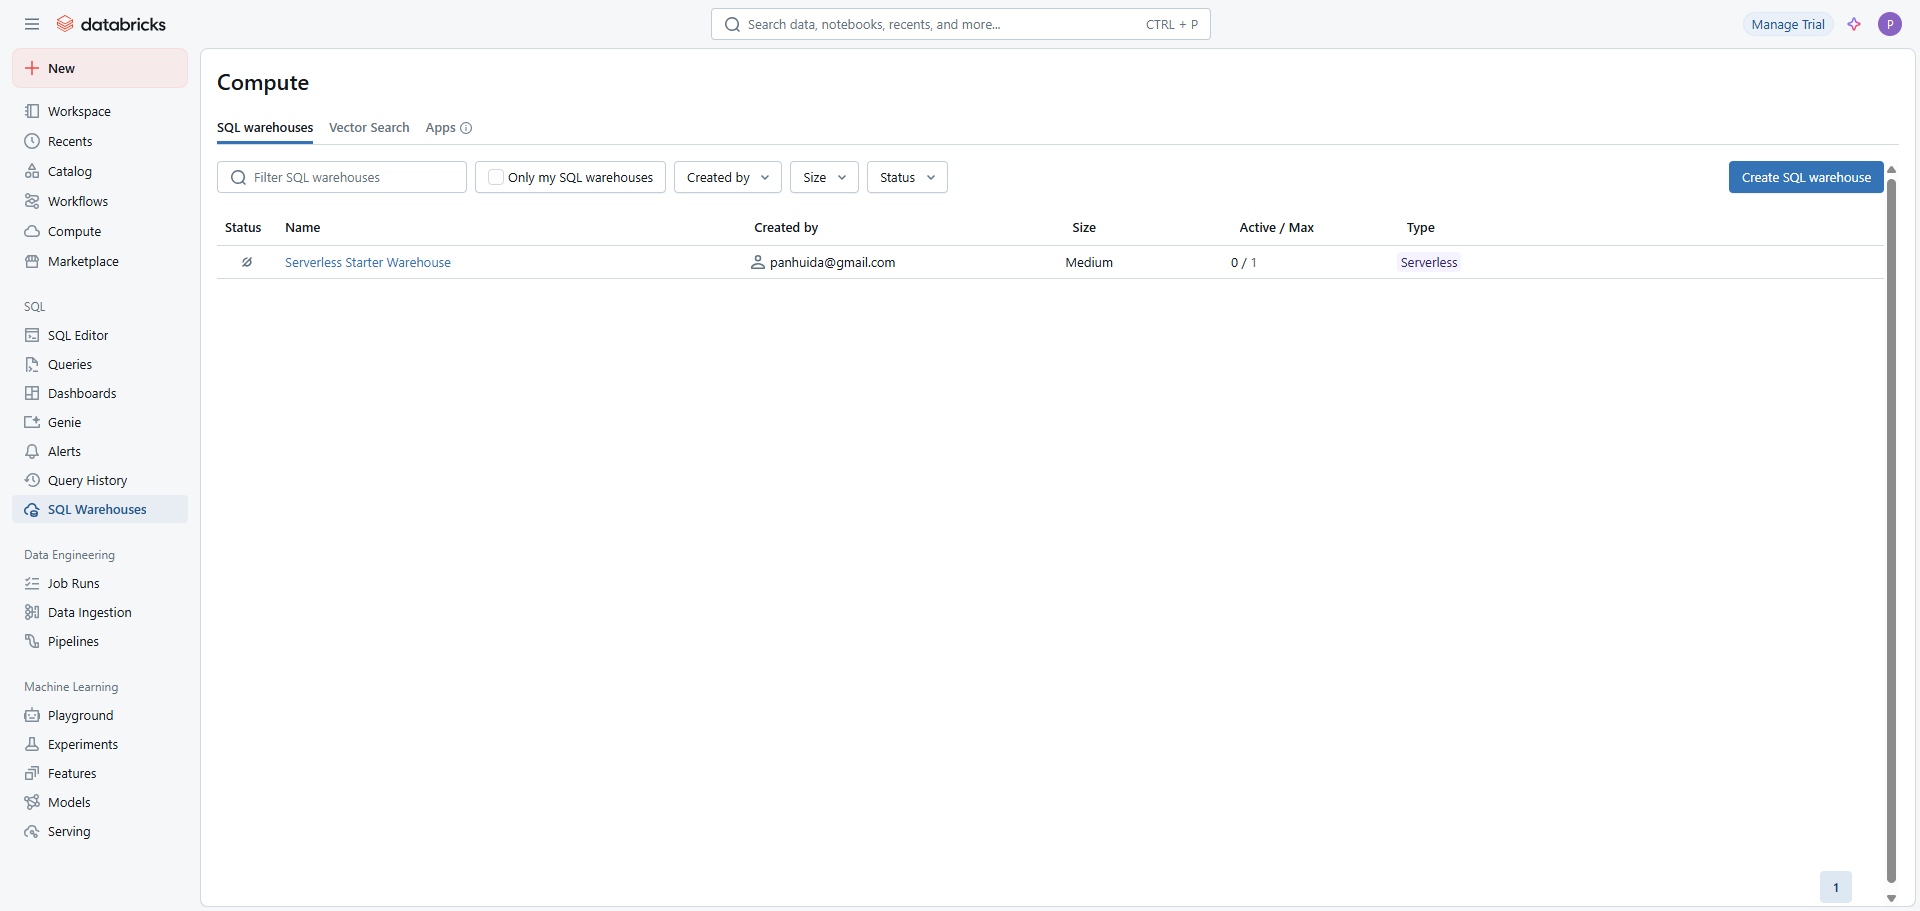
(2)创建 SQL warehouse
默认会创建 Serverless Starter Warehouse ,没有的话创建一个。在 SQL warehouse 里创建 personal access token 。
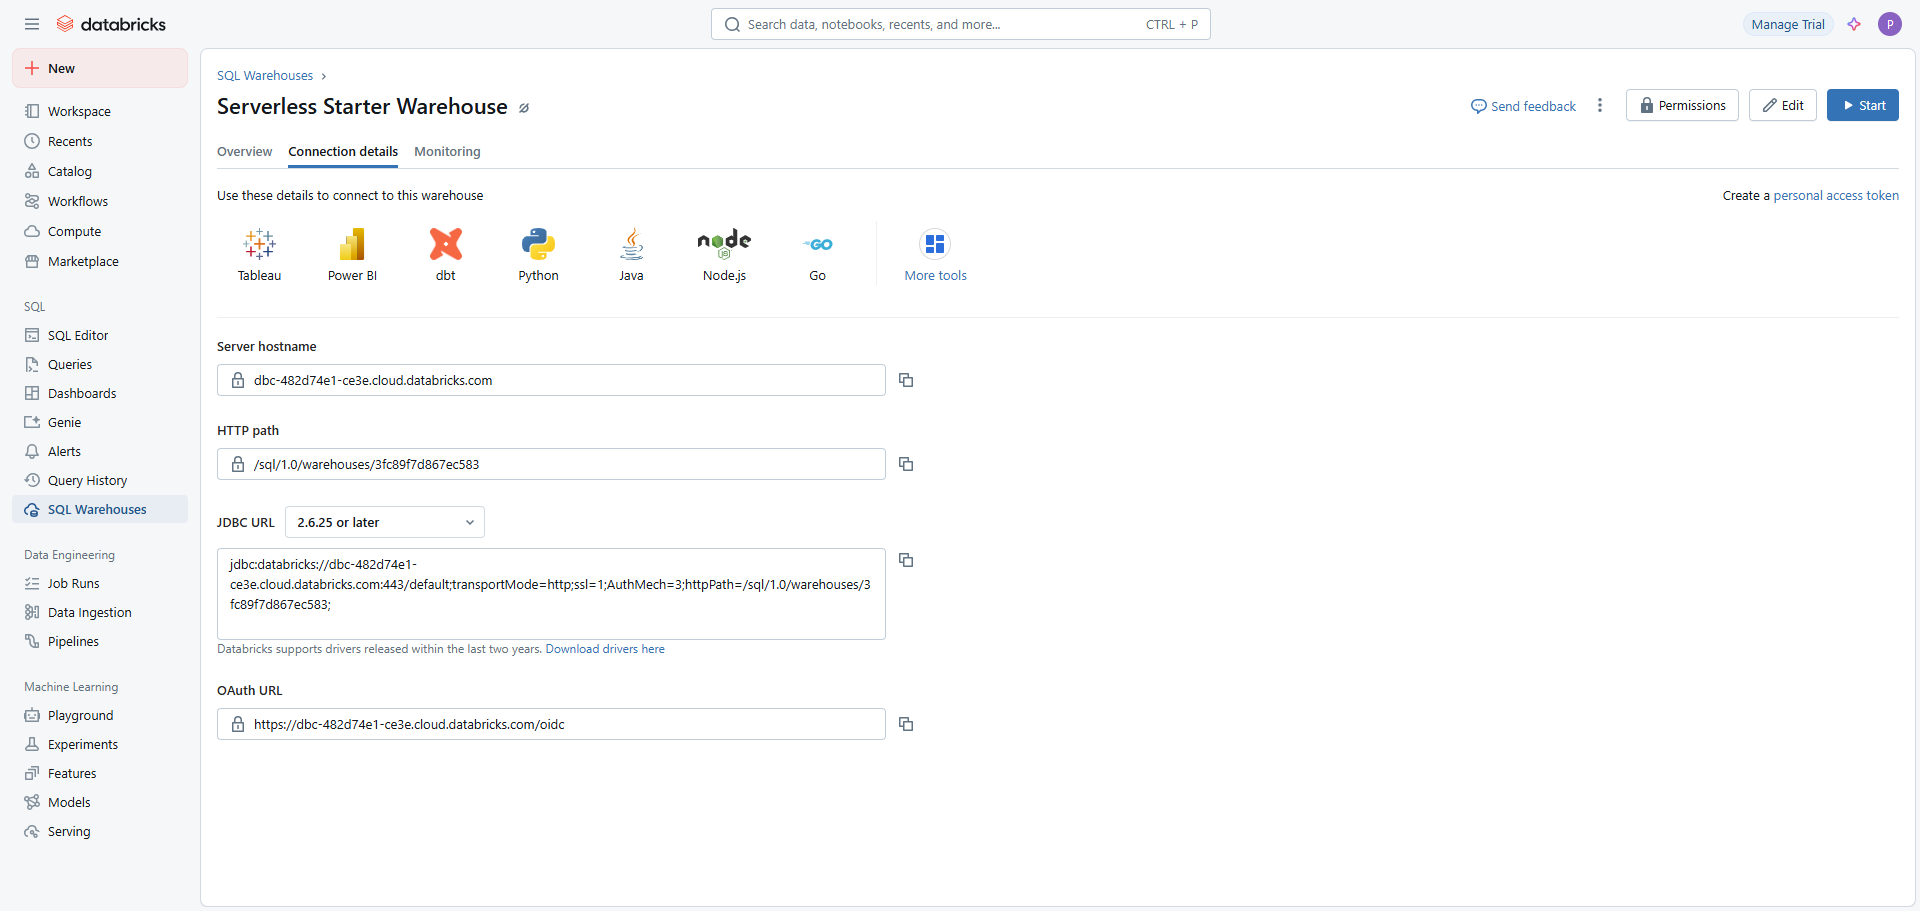
# Airflow 连接 Databricks 会用到
SQL Warehouse: Serverless Starter Warehouse
Server hostname: dbc-482d74e1-ce3e.cloud.databricks.com
HTTP path: /sql/1.0/warehouses/3fc89f7d867ec583
personal access token: da
4. 在 Astro 中增加连接
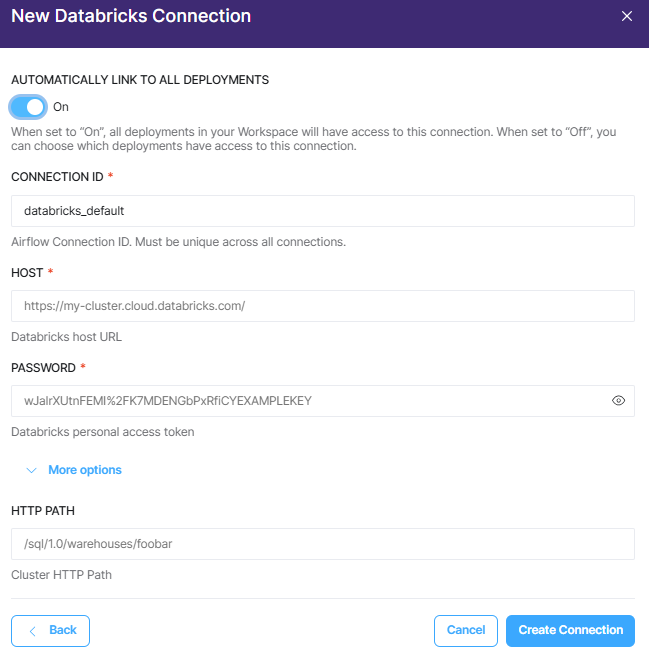
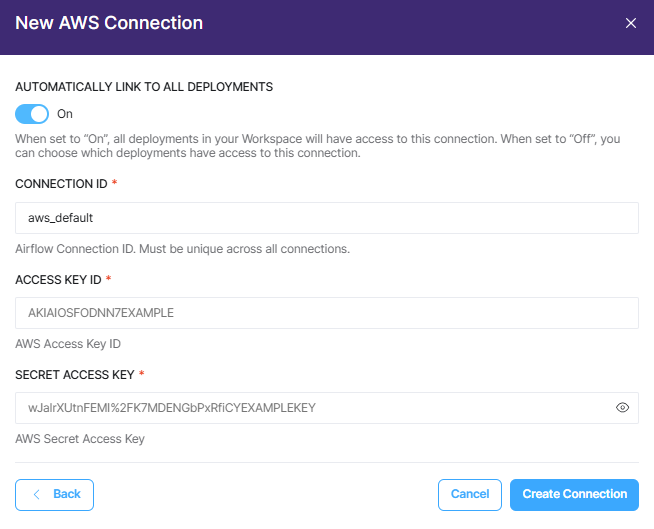
在 Astro 主界面,导航到 “Environment > Connections” ,创建 Connection。
(1)增加 Databricks 连接 databricks_default
(2)增加 AWS 连接 aws_default
5. 在 Databricks 中 创建 Databricks Notebook
https://dbc-482d74e1-ce3e.cloud.databricks.com/browse
在 Databricks 主界面,导航到 “new > Notebook” ,创建 notebook 。
# 要创建的 notebook
# 用于转换
notebook 名称: candy_notebook_1
# 用于分析
notebook 名称: candy_notebook_2
(1)candy_notebook_1
代码如下
from pyspark.sql.types import IntegerType, FloatType
from pyspark.sql.functions import col, sum, avg

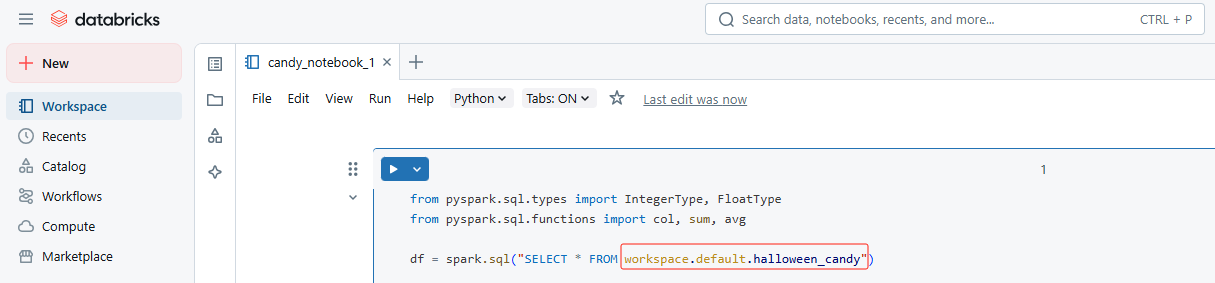
df = spark.sql("SELECT * FROM workspace.default.halloween_candy")


df = df.withColumn("House_1_Amount", col("House_1_Amount").cast(IntegerType()))
df = df.withColumn("House_1_Tastiness_Rating", col("House_1_Tastiness_Rating").cast(FloatType()))
df = df.withColumn("House_2_Amount", col("House_2_Amount").cast(IntegerType()))
df = df.withColumn("House_2_Tastiness_Rating", col("House_2_Tastiness_Rating").cast(FloatType()))
df = df.withColumn("House_3_Amount", col("House_3_Amount").cast(IntegerType()))
df = df.withColumn("House_3_Tastiness_Rating", col("House_3_Tastiness_Rating").cast(FloatType()))

stats_df = (
    df.select(
        col("House_1_Amount").alias("Candy_Amount_H1"),
        col("House_1_Tastiness_Rating").alias("Tastiness_H1"),
        col("House_2_Amount").alias("Candy_Amount_H2"),
        col("House_2_Tastiness_Rating").alias("Tastiness_H2"),
        col("House_3_Amount").alias("Candy_Amount_H3"),
        col("House_3_Tastiness_Rating").alias("Tastiness_H3"),
    )
    .agg(
        sum(col("Candy_Amount_H1")).alias("Total_Candy_H1"),
        avg(col("Tastiness_H1")).alias("Avg_Tastiness_H1"),
        sum(col("Candy_Amount_H2")).alias("Total_Candy_H2"),
        avg(col("Tastiness_H2")).alias("Avg_Tastiness_H2"),
        sum(col("Candy_Amount_H3")).alias("Total_Candy_H3"),
        avg(col("Tastiness_H3")).alias("Avg_Tastiness_H3"),
    )
    .withColumnRenamed("Total_Candy_H1", "House_1_Total_Candy")
    .withColumnRenamed("Avg_Tastiness_H1", "House_1_Avg_Tastiness")
    .withColumnRenamed("Total_Candy_H2", "House_2_Total_Candy")
    .withColumnRenamed("Avg_Tastiness_H2", "House_2_Avg_Tastiness")
    .withColumnRenamed("Total_Candy_H3", "House_3_Total_Candy")
    .withColumnRenamed("Avg_Tastiness_H3", "House_3_Avg_Tastiness")
)

stats_df.write.mode("overwrite").saveAsTable("workspace.default.candy_per_house")
(2)candy_notebook_2
代码如下
import matplotlib.pyplot as plt

stats_df = spark.sql("SELECT * FROM workspace.default.candy_per_house").toPandas()


plt.figure(figsize=(8, 6))
plt.bar(["House 1", "House 2", "House 3"],
        [stats_df['House_1_Total_Candy'][0], stats_df['House_2_Total_Candy'][0], stats_df['House_3_Total_Candy'][0]])
plt.xlabel("House")
plt.ylabel("Total Candy Collected")
plt.title("Total Candy Collected by House")
plt.show()

plt.figure(figsize=(8, 6))
plt.bar(["House 1", "House 2", "House 3"],
        [stats_df['House_1_Avg_Tastiness'][0], stats_df['House_2_Avg_Tastiness'][0], stats_df['House_3_Avg_Tastiness'][0]])
plt.xlabel("House")
plt.ylabel("Average Tastiness Rating")
plt.title("Average Tastiness Rating by House")
plt.show()
6. 创建 GitHub Repository
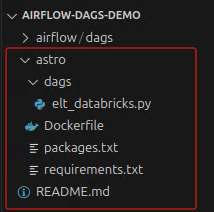
创建一个同步到 Airflow 的 DAG 文件的 GitHub 存储库,并克隆到本地(本文复用 K8s 部署 Airflow 后测试 git-sync 功能创建的存储库)。
git clone https://github.com/panhuida/airflow-dags-demo.git
提示
建议使用 Astro CLI 初始化一个项目,这样保证版本兼容以及项目结构完整,然后发布到 GitHub
https://www.astronomer.io/docs/astro/first-dag-cli/#step-1-install-the-astro-cli
# 安装 Astro CLI
pan@pan-SER8:/opt/code/dp/airflow$ curl -sSL install.astronomer.io | sudo bash -s
# 初始化一个项目
pan@pan-SER8:/opt/code/dp/airflow$ astro dev init astro && cd astro
7. 创建 DAG 文件 及补充相关文件的内容
elt_databricks.py
"""
## ELT S3 to Databricks

This DAG demonstrates how to orchestrate an ELT pipeline from S3 to Databricks.
Steps:
1. Create a table in Databricks
2. Retrieve temporary credentials for S3 access
3. Copy data from S3 to Databricks (Extract and Load)
4. Run two Databricks notebooks in a Databricks Job (Transform)
"""

from airflow.decorators import dag, task
from airflow.models import Variable
from airflow.models.baseoperator import chain
from airflow.providers.amazon.aws.hooks.base_aws import AwsGenericHook
from airflow.providers.databricks.operators.databricks import DatabricksNotebookOperator
from airflow.providers.databricks.operators.databricks_sql import (
    DatabricksCopyIntoOperator,
    DatabricksSqlOperator,
)
from airflow.providers.databricks.operators.databricks_workflow import (
    DatabricksWorkflowTaskGroup,
)
from pendulum import datetime


# ----------------------------------- START CONFIG ------------------------- #
# TODO replace with your values

_NOTEBOOK_PATH_ONE = "/Users/panhuida@gmail.com/candy_notebook_1"
_NOTEBOOK_PATH_TWO = "/Users/panhuida@gmail.com/candy_notebook_2"
_S3_BUCKET = "molihua-warehouse"
_DBX_WH_HTTP_PATH = "/sql/1.0/warehouses/3fc89f7d867ec583"
_S3_BUCKET_ACCESS_ROLE_ARN = "arn:aws:iam::852634928523:role/databricks"

# ----------------------------------- END CONFIG --------------------------- #


_DBX_CONN_ID = "databricks_default"
# 使用 Serverless Compute,移除
# _DATABRICKS_JOB_CLUSTER_KEY = "test-cluster"
_DATABRICKS_TABLE_NAME = "halloween_candy"
_S3_INGEST_KEY_URI = f"s3://{_S3_BUCKET}/"

# 使用 Serverless Compute,移除
# job_cluster_spec = [
#     {
#         "job_cluster_key": _DATABRICKS_JOB_CLUSTER_KEY,
#         "new_cluster": {
#             "cluster_name": "",
#             "spark_version": "15.3.x-cpu-ml-scala2.12",
#             "aws_attributes": {
#                 "first_on_demand": 1,
#                 "availability": "SPOT_WITH_FALLBACK",
#                 "zone_id": "eu-central-1",
#                 "spot_bid_price_percent": 100,
#                 "ebs_volume_count": 0,
#             },
#             "node_type_id": "i3.xlarge",
#             "spark_env_vars": {"PYSPARK_PYTHON": "/databricks/python3/bin/python3"},
#             "enable_elastic_disk": False,
#             "data_security_mode": "LEGACY_SINGLE_USER_STANDARD",
#             "runtime_engine": "STANDARD",
#             "num_workers": 1,
#         },
#     }
# ]


@dag(
    dag_display_name="ELT Databricks",
    start_date=datetime(2024, 11, 1),
    schedule="@daily",
    catchup=False,
    tags=["DBX"],
)
def elt_databricks():

    @task
    def get_tmp_creds(role_arn):
        from airflow.models import Variable

        session_name = "airflow-session"
        hook = AwsGenericHook(aws_conn_id="aws_default")
        client = hook.get_session().client("sts")
        response = client.assume_role(RoleArn=role_arn, RoleSessionName=session_name)

        credentials = response["Credentials"]

        Variable.set(key="AWSACCESSKEYTMP", value=credentials["AccessKeyId"])
        Variable.set(key="AWSSECRETKEYTMP", value=credentials["SecretAccessKey"])
        Variable.set(key="AWSSESSIONTOKEN", value=credentials["SessionToken"])
        print(f"--------credentials--------:{credentials}")


    get_tmp_creds_obj = get_tmp_creds(role_arn=_S3_BUCKET_ACCESS_ROLE_ARN)

    create_table_delta_lake = DatabricksSqlOperator(
        task_id="create_table_delta_lake",
        databricks_conn_id=_DBX_CONN_ID,
        http_path=_DBX_WH_HTTP_PATH,
        sql="""CREATE TABLE IF NOT EXISTS halloween_candy (
            Kid STRING,
            Costume STRING,
            House_1_Candy STRING,
            House_1_Amount INT,
            House_1_Tastiness_Rating INT,
            House_2_Candy STRING,
            House_2_Amount INT,
            House_2_Tastiness_Rating INT,
            House_3_Candy STRING,
            House_3_Amount INT,
            House_3_Tastiness_Rating INT
        );""",
    )

    s3_to_delta_lake = DatabricksCopyIntoOperator(
        task_id="s3_to_delta_lake",
        databricks_conn_id=_DBX_CONN_ID,
        table_name=_DATABRICKS_TABLE_NAME,
        file_location=_S3_INGEST_KEY_URI,
        file_format="CSV",
        format_options={"header": "true", "inferSchema": "true"},
        force_copy=True,
        http_path=_DBX_WH_HTTP_PATH,
        credential={
            "AWS_ACCESS_KEY": Variable.get("AWSACCESSKEYTMP", "Notset"),
            "AWS_SECRET_KEY": Variable.get("AWSSECRETKEYTMP", "Notset"),
            "AWS_SESSION_TOKEN": Variable.get("AWSSESSIONTOKEN", "Notset"),
        },
        copy_options={"mergeSchema": "true"},
    )

    dbx_workflow_task_group = DatabricksWorkflowTaskGroup(
        group_id="databricks_workflow",
        databricks_conn_id=_DBX_CONN_ID,
        # 使用 Serverless Compute,移除
        # job_clusters=job_cluster_spec,
    )

    with dbx_workflow_task_group:

        transform_one = DatabricksNotebookOperator(
            task_id="transform_one",
            databricks_conn_id=_DBX_CONN_ID,
            notebook_path=_NOTEBOOK_PATH_ONE,
            source="WORKSPACE",
            # 使用 Serverless Compute,移除
            # job_cluster_key=_DATABRICKS_JOB_CLUSTER_KEY,
        )

        transform_two = DatabricksNotebookOperator(
            task_id="transform_two",
            databricks_conn_id=_DBX_CONN_ID,
            notebook_path=_NOTEBOOK_PATH_TWO,
            source="WORKSPACE",
            # 使用 Serverless Compute,移除
            # job_cluster_key=_DATABRICKS_JOB_CLUSTER_KEY,
        )

        chain(transform_one, transform_two)

    chain(
        [create_table_delta_lake, get_tmp_creds_obj],
        s3_to_delta_lake,
        dbx_workflow_task_group,
    )


elt_databricks()
Dockerfile
FROM astrocrpublic.azurecr.io/runtime:3.0-1
requirements.txt
apache-airflow-providers-amazon==9.6.1
apache-airflow-providers-databricks==7.3.2
apache-airflow-providers-fab==2.0.2
**8. 在 Astro 中 配置 Git Deploys **
https://www.astronomer.io/docs/astro/deploy-github-integration/
配置 Airflow 的 DAG 文件从 GitHub 自动同步。
在 Astro 主界面,导航到 “Workspace Settings > Git Deploys” ,按文档操作。
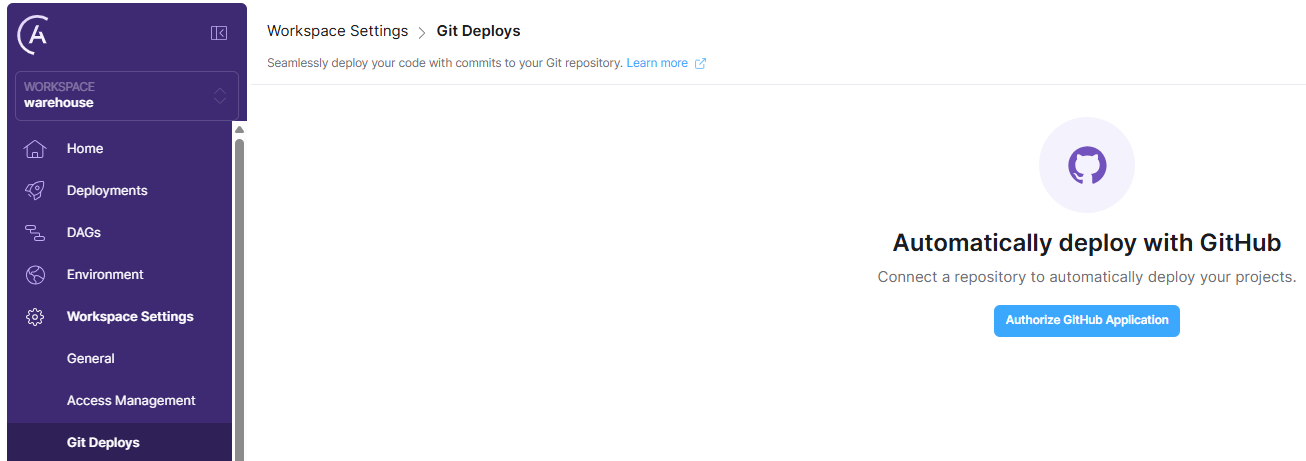
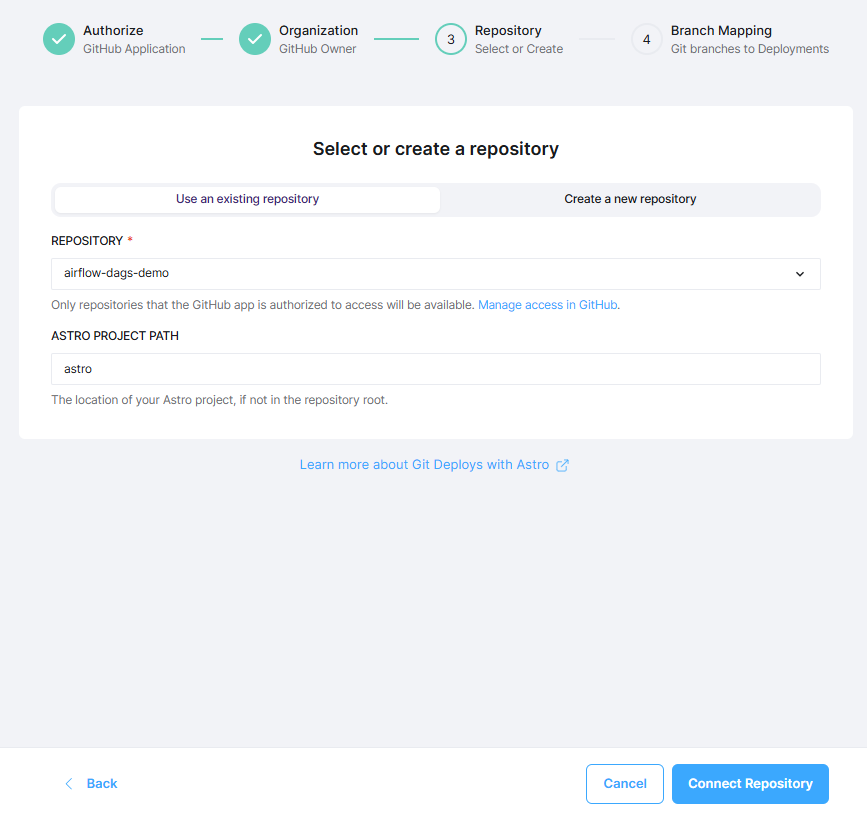
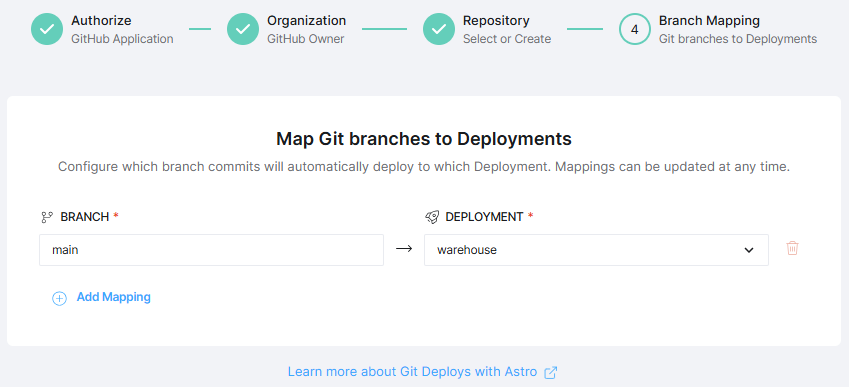
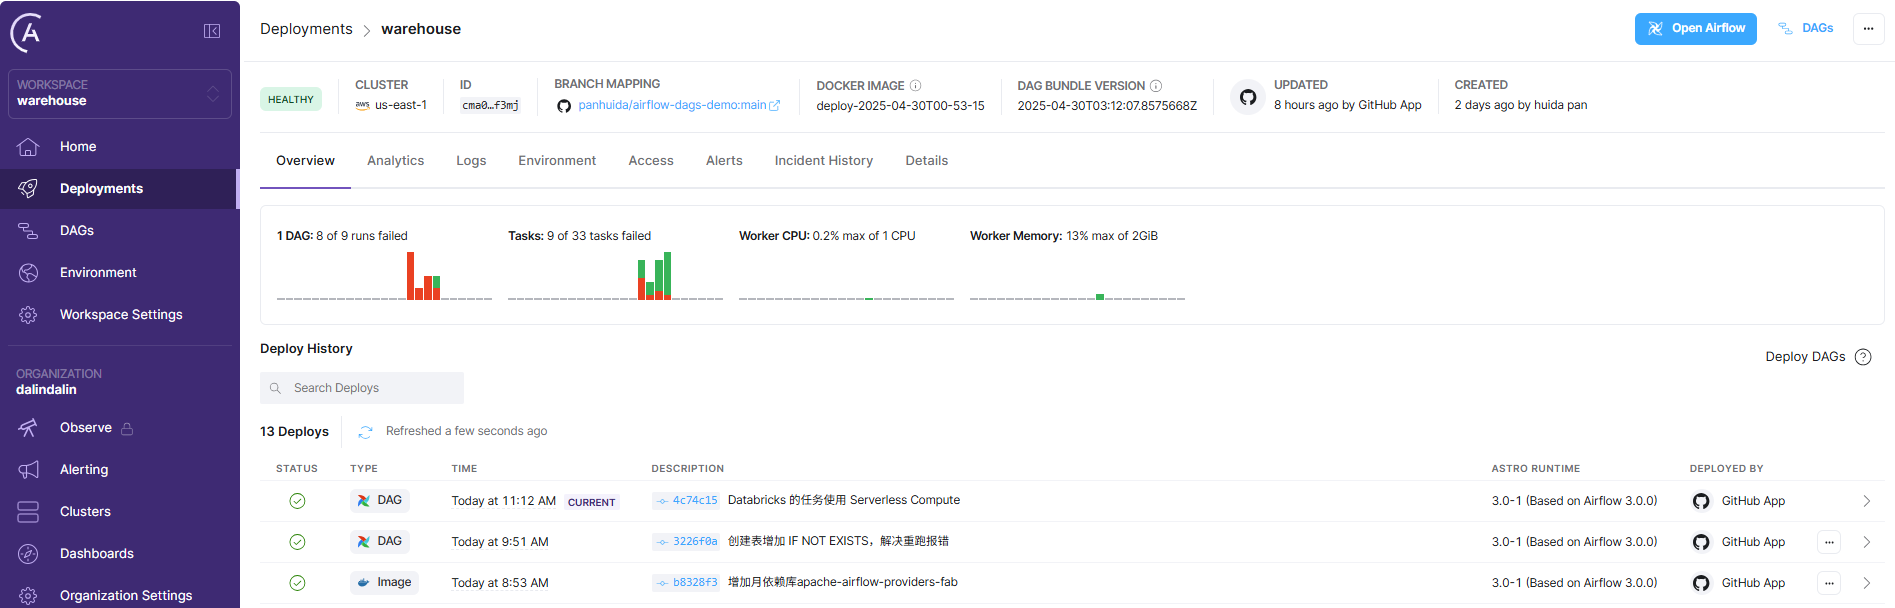
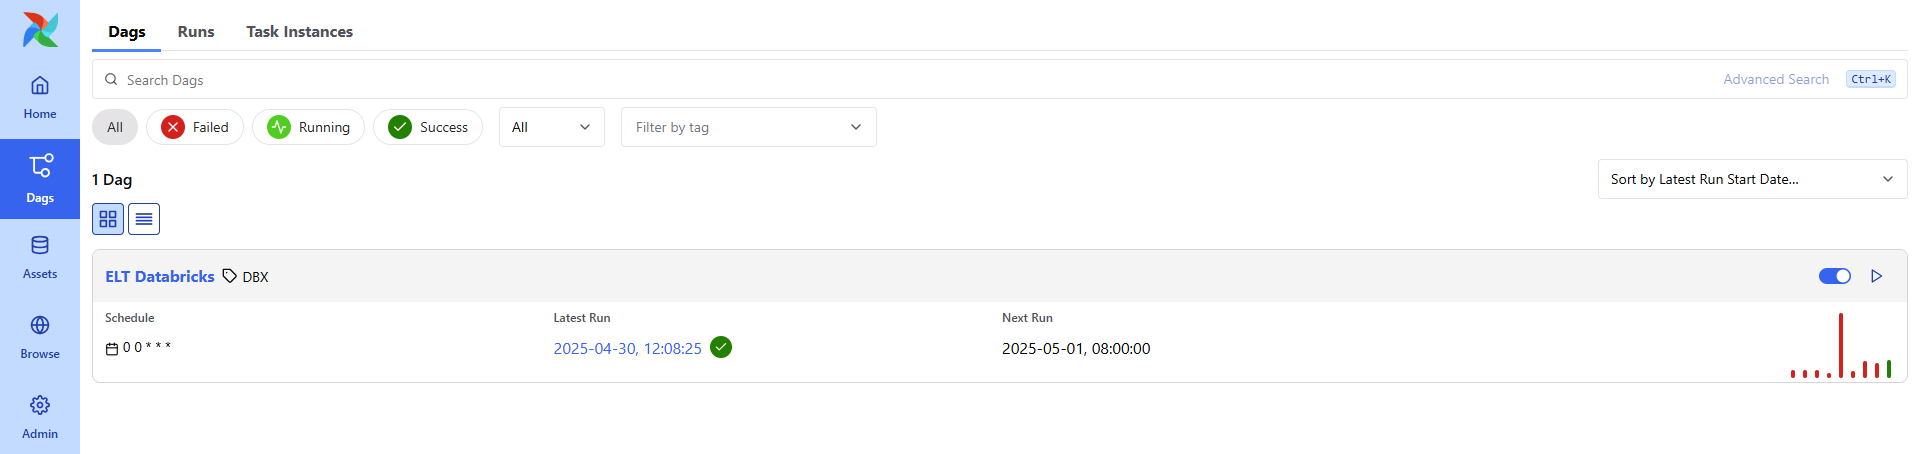
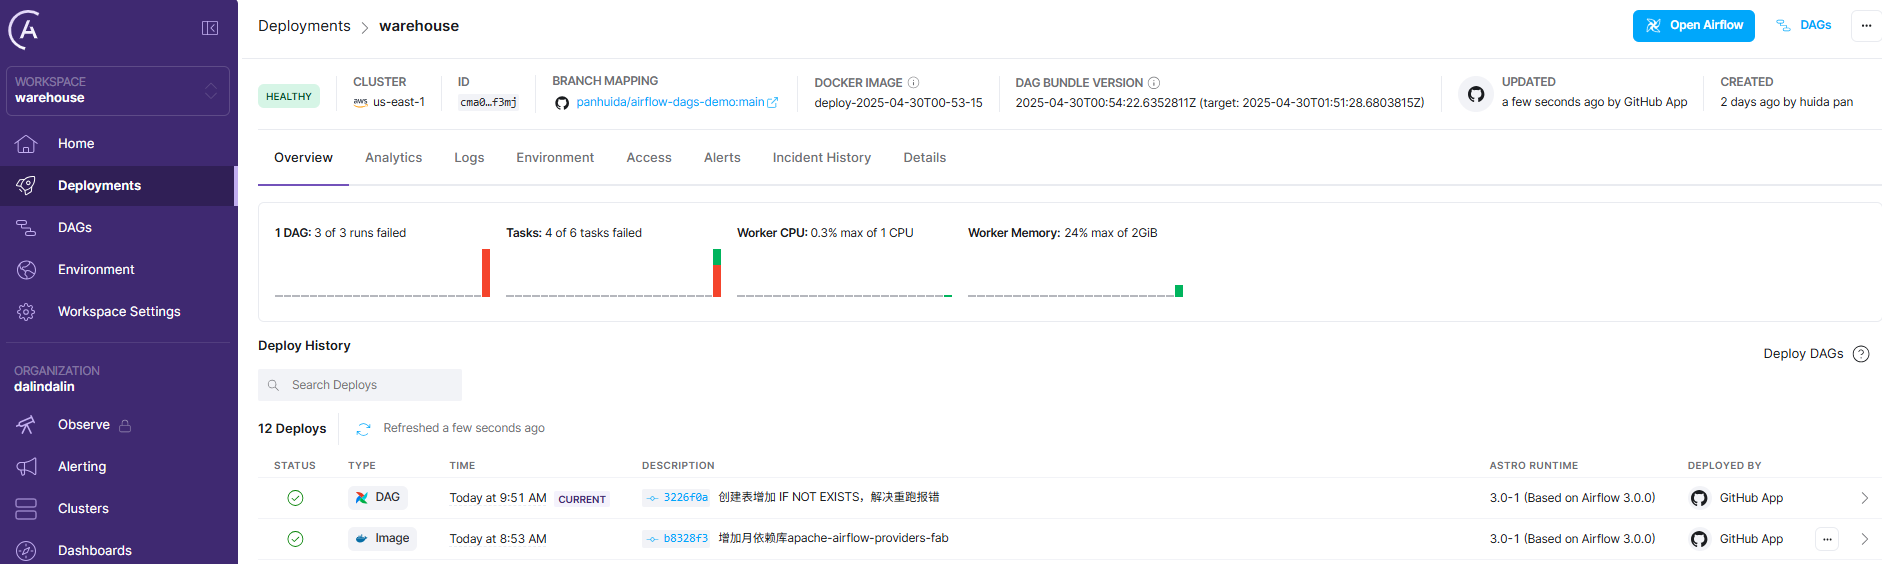
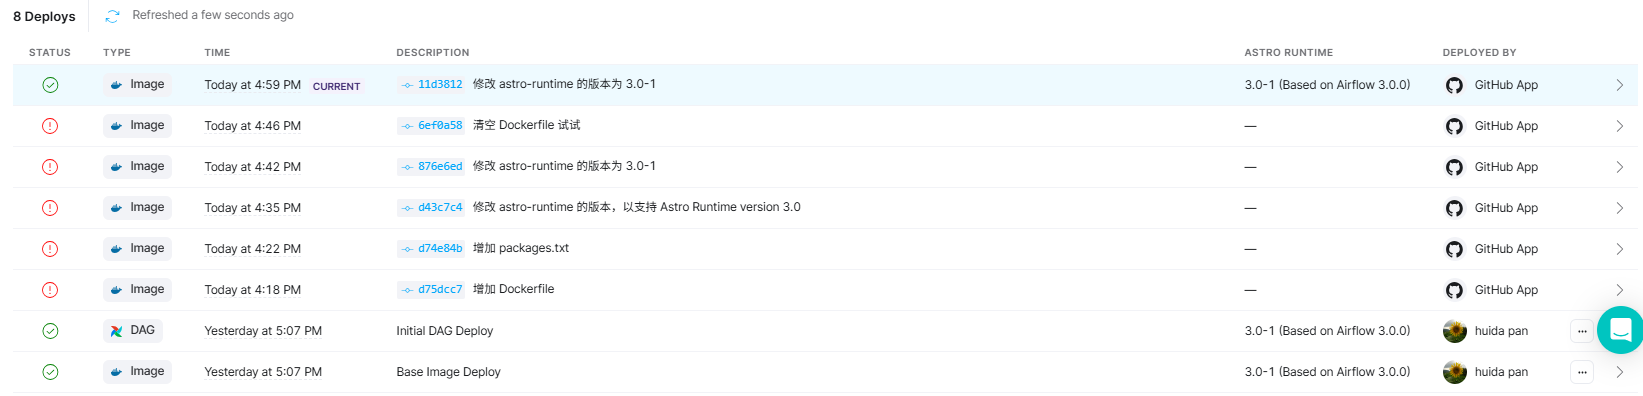
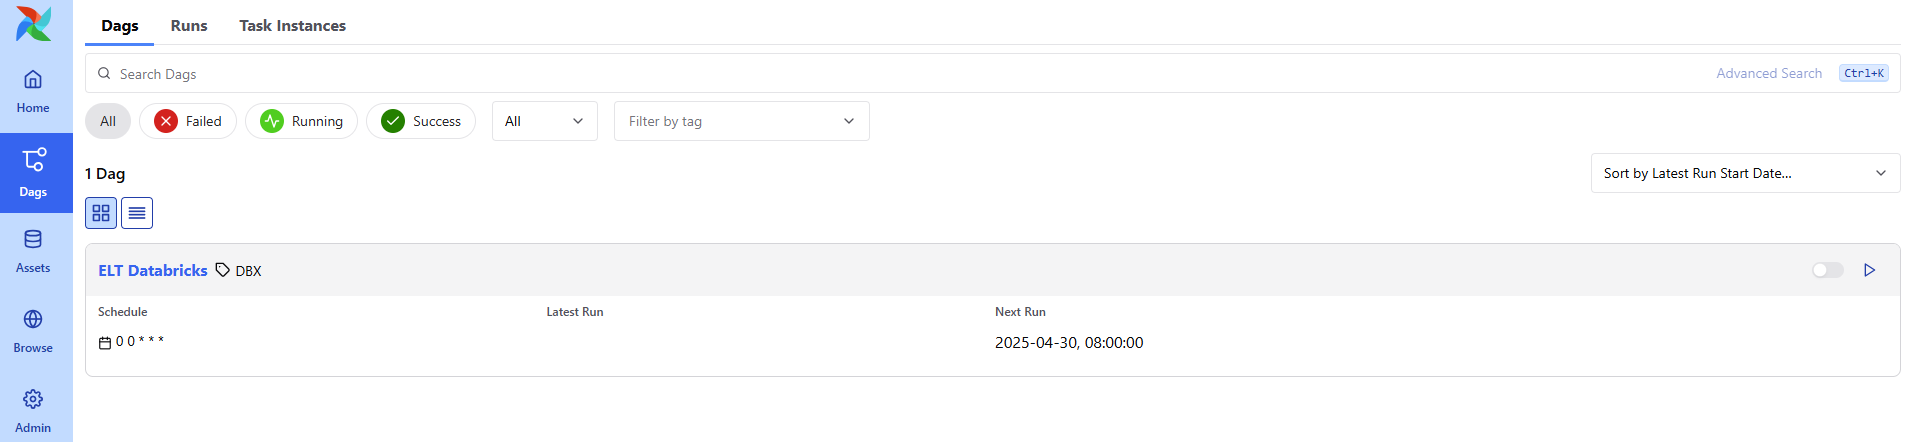
配置 Git Deploys 后,在 Deployments 界面(Deployments > warehouse )可以查看部署的情况,在 Airflow 的 Dags 界面可以查看同步的 DAG。
DAG 部署情况
DAG 列表
04 运行
1. 流程
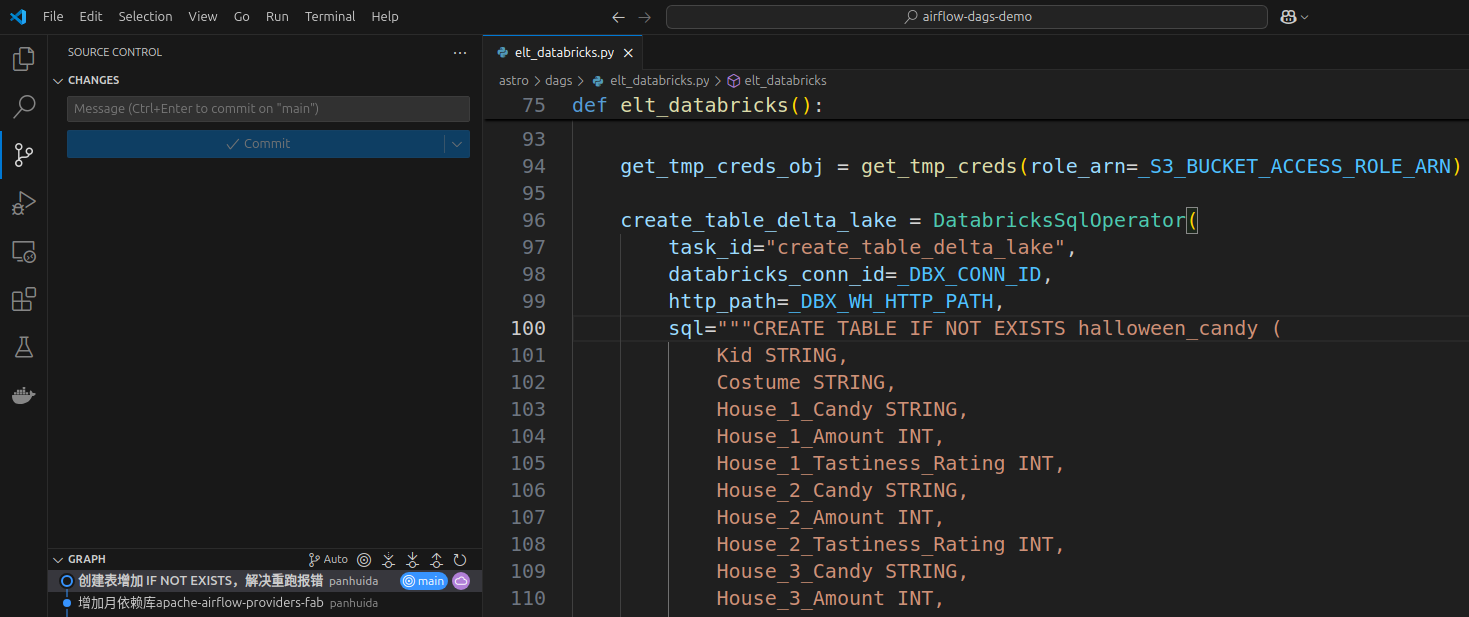
(1)在 IDE 修改后提交到 GitHub
(2)Astro 会自动从 GitHub 拉取代码部署
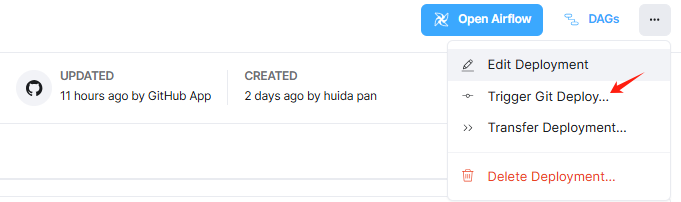
如果没有自动同步,手动触发
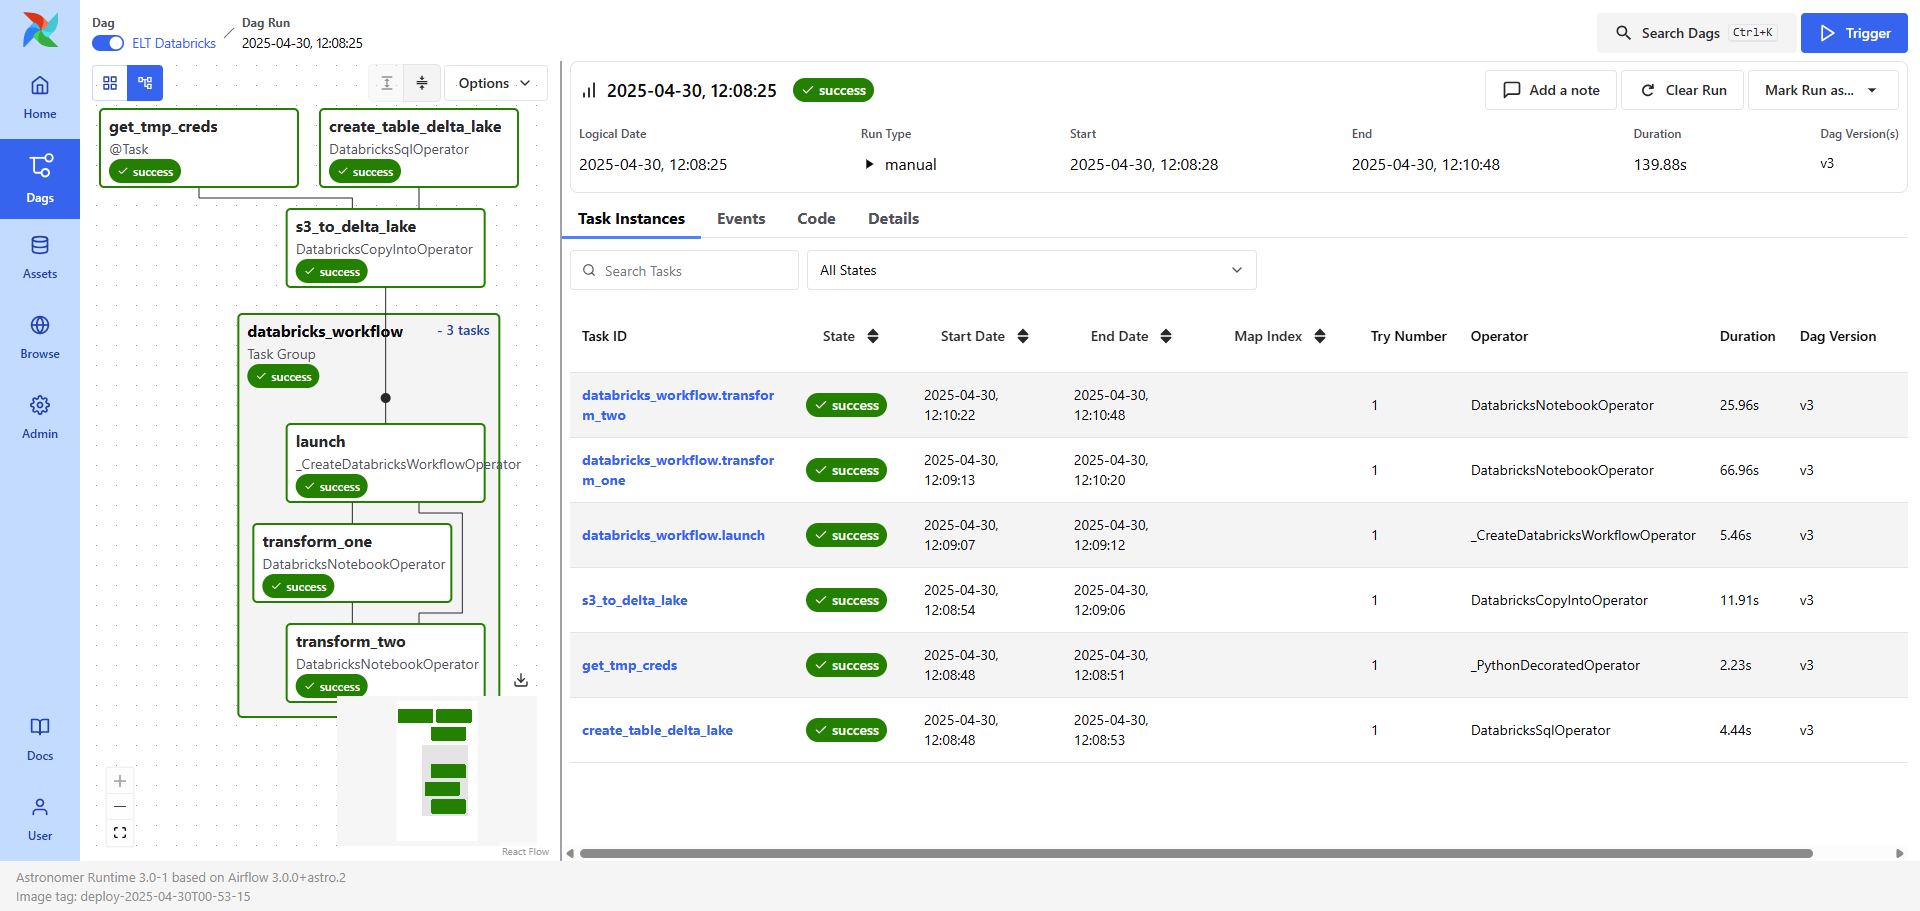
(3)在 Airflow 中触发执行 DAG
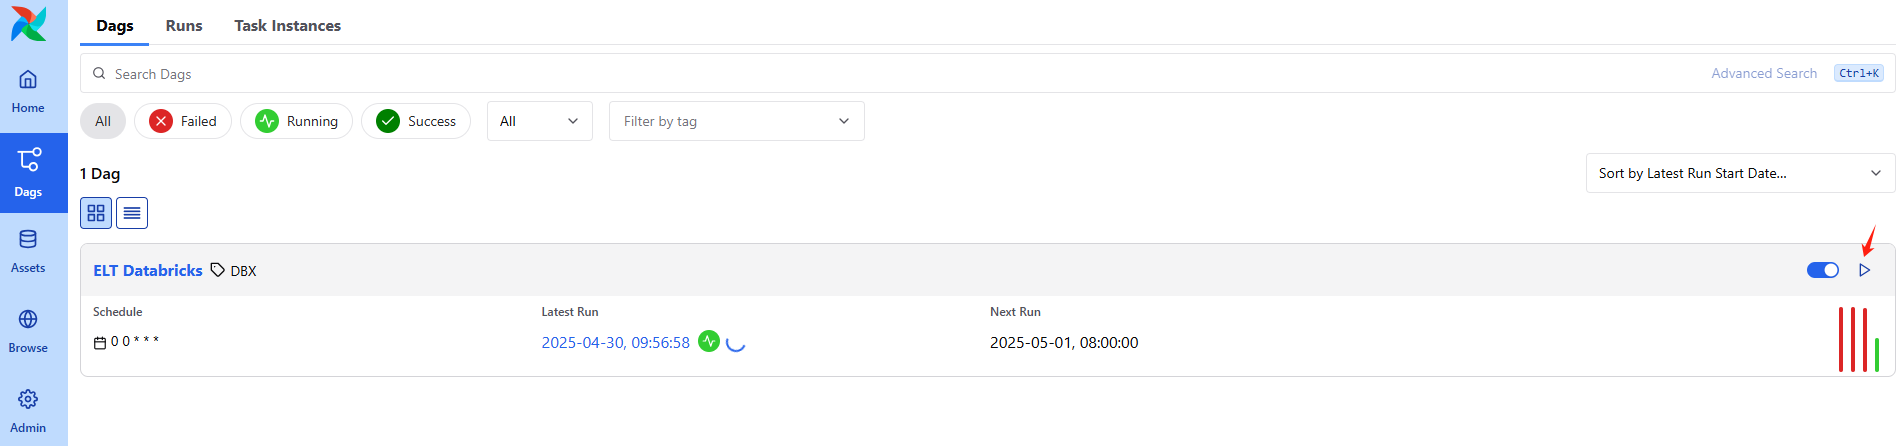
DAG 执行详情
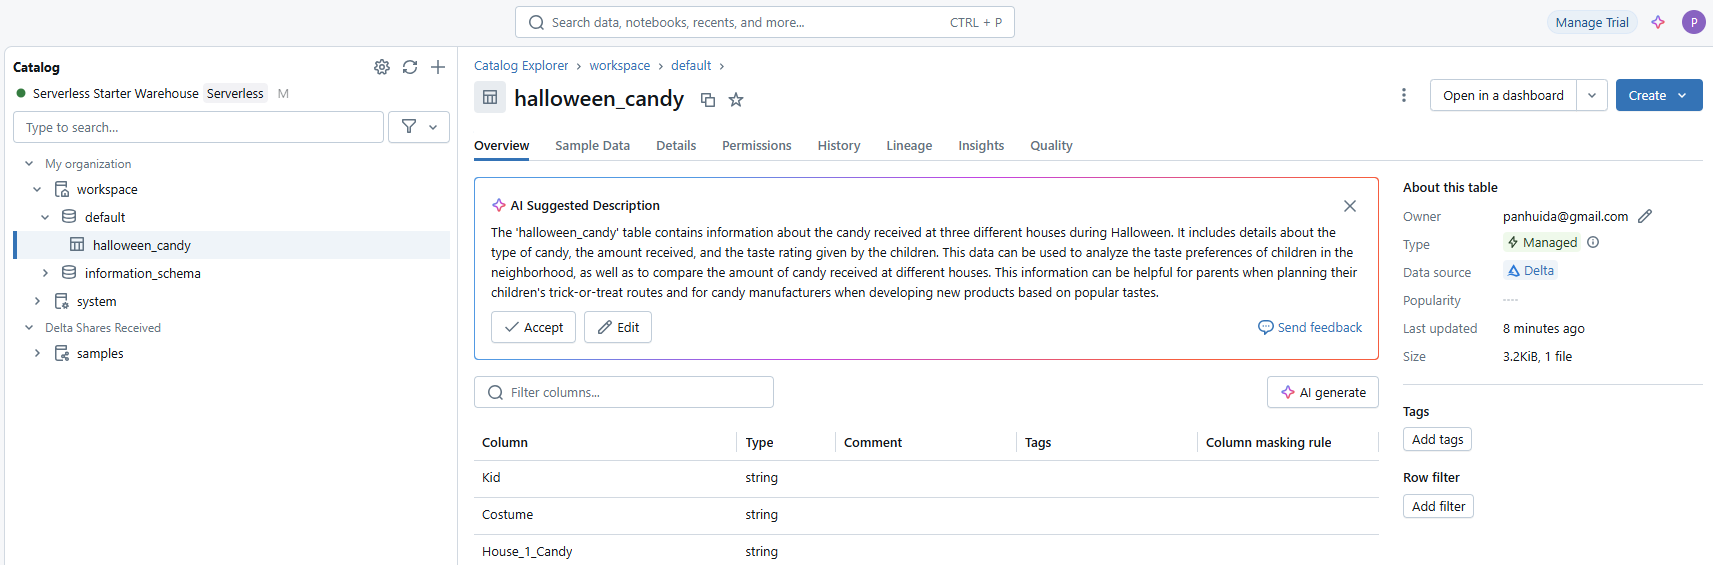
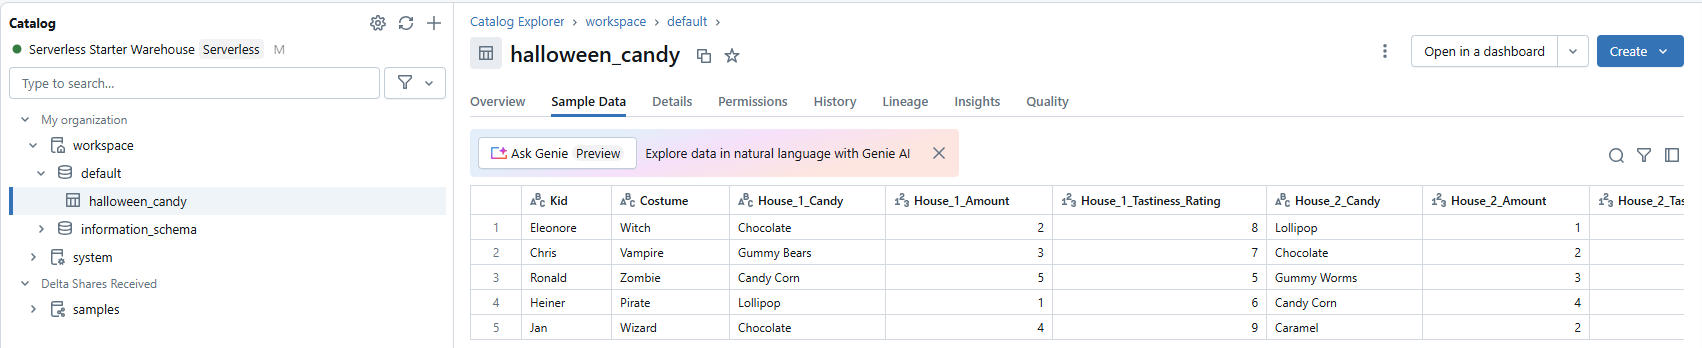
(4)在 Databricks 上查看数据表
数据表
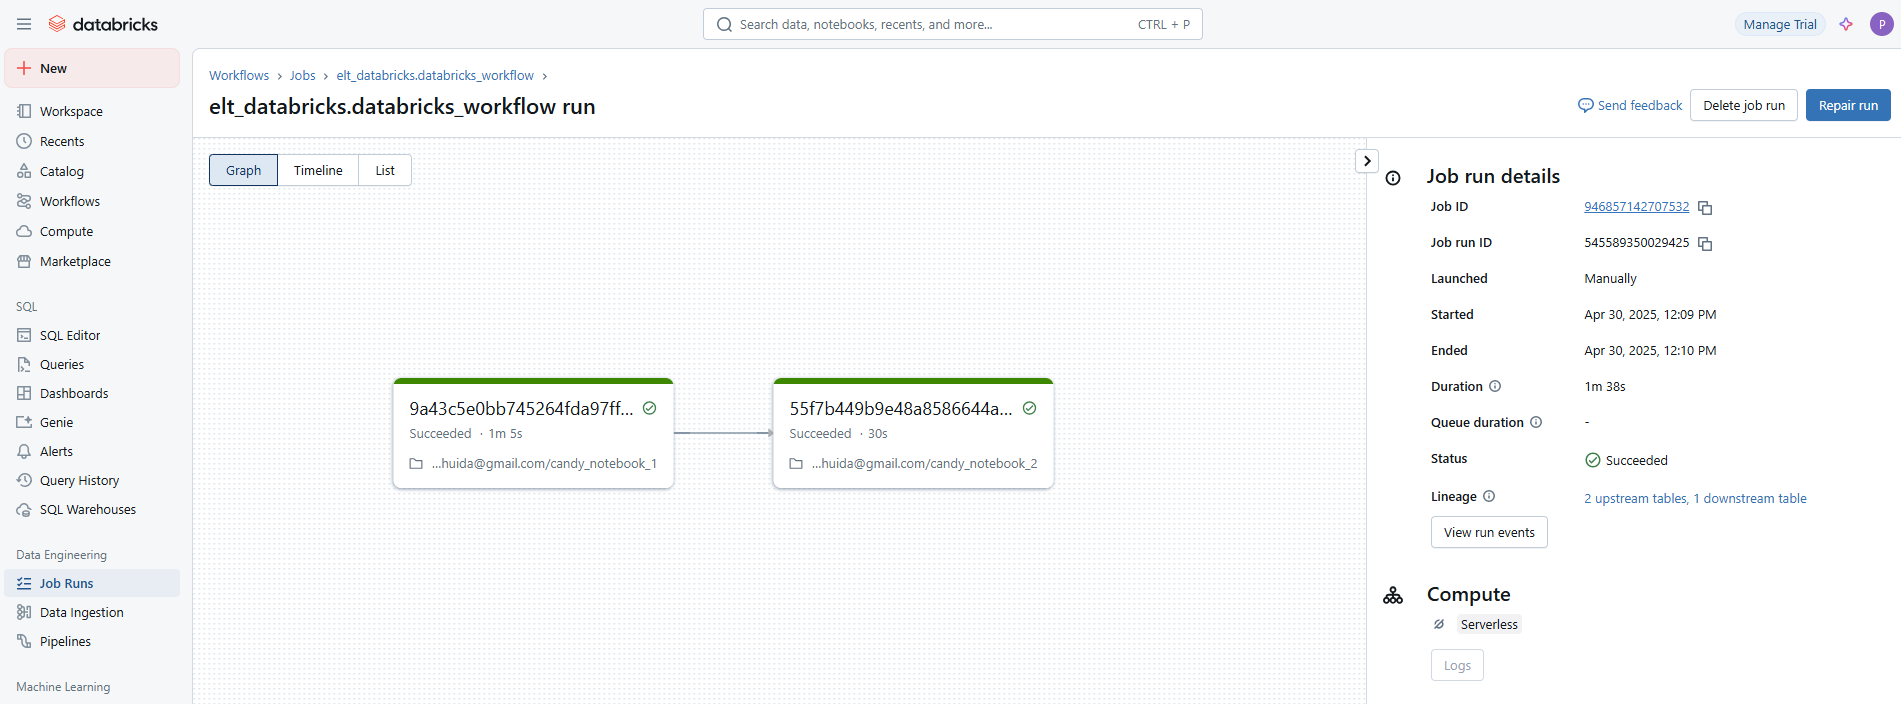
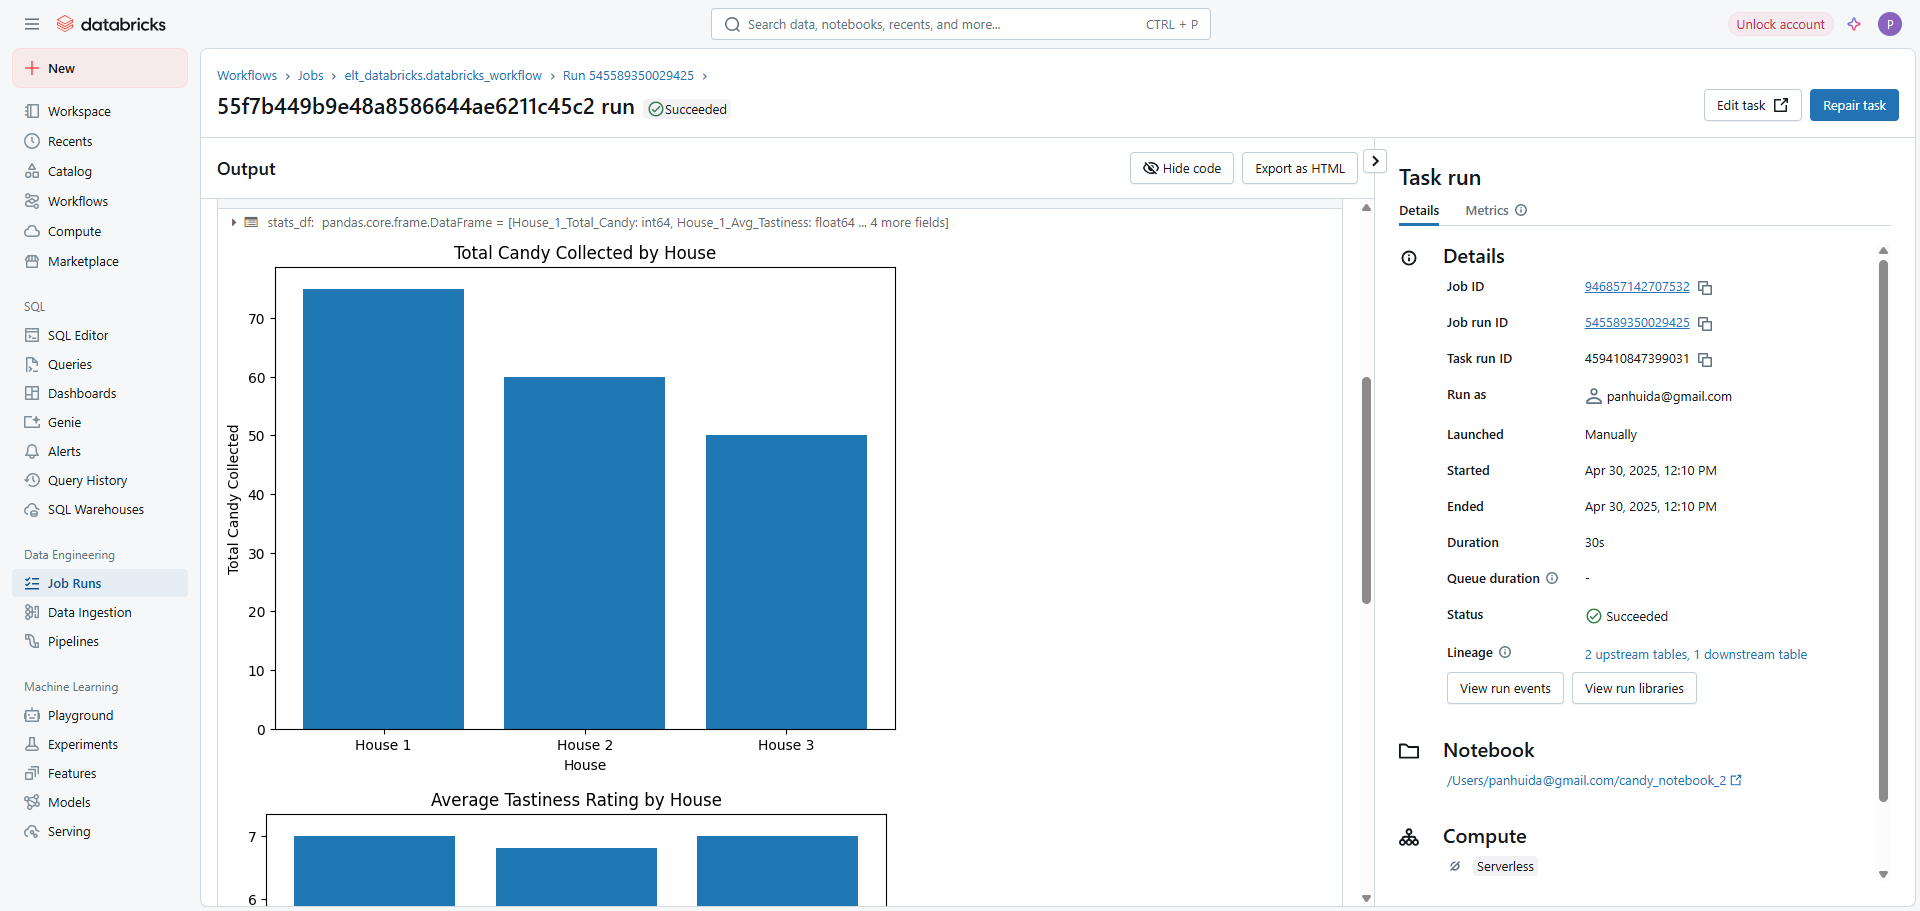
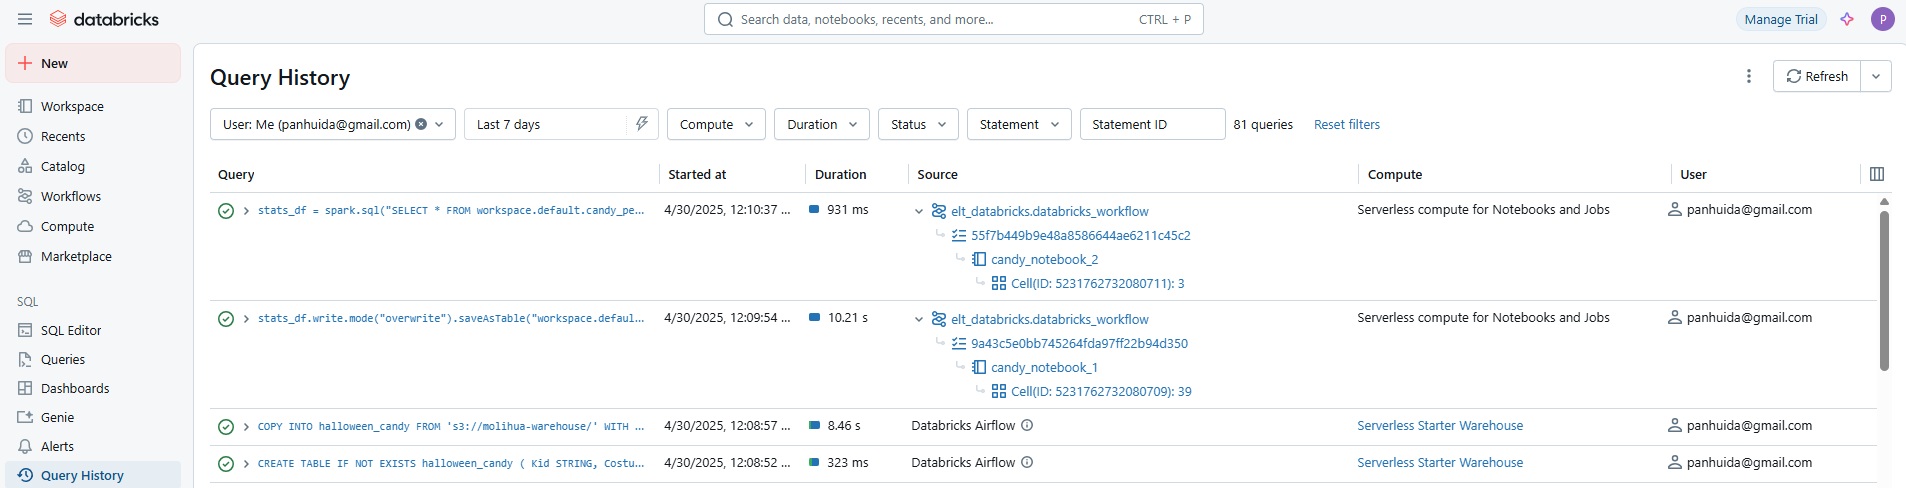
(5)在 Databricks 上查看任务情况
Workflows
Query History
05 问题
1. 部署 DAG 到 Astro 出现问题
(1)部署失败
Invalid request: Astro project not found at path 'astro' in repository panhuida/airflow-dags-demo: missing Dockerfile

Image Astro Runtime version 12.6.0 is less than current deployment Astro Runtime version 3.0-1 (type: CoreError, retryable: true)
解决方案
参考官方 https://github.com/astronomer/astro-example-dags 的结构,参考 Astro CLI 初始化的一个Astro 项目的结构,增加 Dockerfile、packages.txt 、requirements.txt 文件,修改镜像 astro-runtime 的版本
部署日志
Build and push image
1
16:59:41 PM:
warning: unsuccessful cred copy: ".git-credentials" from "/tekton/creds" to "/root": unable to open destination: open /root/.git-credentials: no such file or directory
2
16:59:41 PM:
warning: unsuccessful cred copy: ".gitconfig" from "/tekton/creds" to "/root": unable to open destination: open /root/.gitconfig: no such file or directory
3
16:59:44 PM:
Retrieving image astrocrpublic.azurecr.io/runtime:3.0-1 from registry astrocrpublic.azurecr.io
4
16:59:44 PM:
Retrieving image manifest astrocrpublic.azurecr.io/runtime:3.0-1
5
16:59:48 PM:
Returning cached image manifest
6
16:59:48 PM:
Retrieving image manifest astrocrpublic.azurecr.io/runtime:3.0-1
7
16:59:48 PM:
Returning cached image manifest
8
16:59:48 PM:
Retrieving image manifest astrocrpublic.azurecr.io/runtime:3.0-1
9
16:59:48 PM:
Returning cached image manifest
10
16:59:48 PM:
Retrieving image manifest astrocrpublic.azurecr.io/runtime:3.0-1
11
16:59:48 PM:
Built cross stage deps: map[]
12
16:59:48 PM:
Checking for cached layer images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj/cache:cfddd3dfba003c91ff57337df8a1979aae7760b6bd7d98a2e0c17e8c52ff6eae...
13
16:59:48 PM:
Cmd: USER
14
16:59:48 PM:
Building stage 'astrocrpublic.azurecr.io/runtime:3.0-1' [idx: '0', base-idx: '-1']
15
16:59:48 PM:
Executing 7 build triggers
16
16:59:48 PM:
Unpacking rootfs as cmd COPY packages.txt . requires it.
17
16:59:48 PM:
Cmd: USER
18
16:59:48 PM:
No cached layer found for cmd RUN /usr/local/bin/install-system-packages
19
17:00:00 PM:
Taking snapshot of files...
20
17:00:00 PM:
COPY packages.txt .
21
17:00:00 PM:
Taking snapshot of full filesystem...
22
17:00:00 PM:
Initializing snapshotter ...
23
17:00:00 PM:
RUN /usr/local/bin/install-system-packages
24
17:00:00 PM:
No files changed in this command, skipping snapshotting.
25
17:00:00 PM:
Cmd: USER
26
17:00:00 PM:
USER root
27
17:00:06 PM:
Running: [/bin/bash -o pipefail -e -u -x -c /usr/local/bin/install-system-packages]
28
17:00:06 PM:
Performing slow lookup of group ids for root
29
17:00:06 PM:
Util.Lookup returned: &{Uid:0 Gid:0 Username:root Name: HomeDir:/root}
30
17:00:06 PM:
Args: [-o pipefail -e -u -x -c /usr/local/bin/install-system-packages]
31
17:00:06 PM:
Cmd: /bin/bash
32
17:00:06 PM:
/usr/local/bin/install-system-packages
33
17:00:06 PM:
Taking snapshot of full filesystem...
34
17:00:07 PM:
Pushing layer images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj/cache:cfddd3dfba003c91ff57337df8a1979aae7760b6bd7d98a2e0c17e8c52ff6eae to cache now
35
17:00:07 PM:
Taking snapshot of files...
36
17:00:07 PM:
COPY requirements.txt .
37
17:00:07 PM:
No files were changed, appending empty layer to config. No layer added to image.
38
17:00:07 PM:
Running: [/bin/bash -o pipefail -e -u -x -c /usr/local/bin/install-python-dependencies]
39
17:00:07 PM:
Performing slow lookup of group ids for root
40
17:00:07 PM:
Util.Lookup returned: &{Uid:0 Gid:0 Username:root Name: HomeDir:/root}
41
17:00:07 PM:
Args: [-o pipefail -e -u -x -c /usr/local/bin/install-python-dependencies]
42
17:00:07 PM:
Cmd: /bin/bash
43
17:00:07 PM:
RUN /usr/local/bin/install-python-dependencies
44
17:00:07 PM:
Pushing image to images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj/cache:cfddd3dfba003c91ff57337df8a1979aae7760b6bd7d98a2e0c17e8c52ff6eae
45
17:00:07 PM:
/usr/local/bin/install-python-dependencies
46
17:00:07 PM:
Installing python dependencies using uv
47
17:00:07 PM:
Using Python 3.12.10 environment at: /usr/local
48
17:00:08 PM:
Pushed images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj/cache@sha256:fa7b78fd2fcdcf42e23dd0516a44cdd11a23be4b66e3d289907d6e63efcb6761
49
17:00:09 PM:
Resolved 169 packages in 1.36s
50
17:00:09 PM:
Building thrift==0.20.0
51
17:00:09 PM:
Downloading lxml (4.7MiB)
52
17:00:09 PM:
Downloading botocore (12.9MiB)
53
17:00:09 PM:
Downloading pyarrow (40.3MiB)
54
17:00:09 PM:
Downloading lz4 (1.2MiB)
55
17:00:09 PM:
Downloading xmlsec (3.7MiB)
56
17:00:09 PM:
Downloaded lz4
57
17:00:09 PM:
Downloaded xmlsec
58
17:00:10 PM:
Downloaded lxml
59
17:00:11 PM:
Downloaded pyarrow
60
17:00:11 PM:
Downloaded botocore
61
17:00:11 PM:
Built thrift==0.20.0
62
17:00:11 PM:
Prepared 30 packages in 2.25s
63
17:00:11 PM:
+ xmlsec==1.3.14
64
17:00:11 PM:
+ watchtower==3.4.0
65
17:00:11 PM:
+ thrift==0.20.0
66
17:00:11 PM:
+ soupsieve==2.7
67
17:00:11 PM:
+ setuptools==80.0.0
68
17:00:11 PM:
+ scramp==1.4.5
69
17:00:11 PM:
+ sagemaker-studio==1.0.13
70
17:00:11 PM:
+ s3transfer==0.12.0
71
17:00:11 PM:
+ requests-toolbelt==1.0.0
72
17:00:11 PM:
+ redshift-connector==2.1.5
73
17:00:11 PM:
+ python3-saml==1.16.0
74
17:00:11 PM:
+ pyathena==3.13.0
75
17:00:11 PM:
+ pyarrow==20.0.0
76
17:00:11 PM:
+ ply==3.11
77
17:00:11 PM:
+ openpyxl==3.1.5
78
17:00:11 PM:
+ mergedeep==1.3.4
79
17:00:11 PM:
+ lz4==4.4.4
80
17:00:11 PM:
+ lxml==5.4.0
81
17:00:11 PM:
+ jsonpath-ng==1.7.0
82
17:00:11 PM:
+ jmespath==1.0.1
83
17:00:11 PM:
+ isodate==0.7.2
84
17:00:11 PM:
+ inflection==0.5.1
85
17:00:11 PM:
+ et-xmlfile==2.0.0
86
17:00:11 PM:
+ databricks-sql-connector==4.0.3
87
17:00:11 PM:
+ botocore==1.38.4
88
17:00:11 PM:
+ boto3==1.38.4
89
17:00:11 PM:
+ beautifulsoup4==4.13.4
90
17:00:11 PM:
+ asn1crypto==1.5.1
91
17:00:11 PM:
+ apache-airflow-providers-http==5.2.2
92
17:00:11 PM:
+ apache-airflow-providers-databricks==7.3.2
93
17:00:11 PM:
+ apache-airflow-providers-amazon==9.6.1
94
17:00:11 PM:
Installed 31 packages in 101ms
95
17:00:11 PM:
Taking snapshot of full filesystem...
96
17:00:20 PM:
Pushing image to images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj/cache:9cace808fb41dc7e5da295cf073cdbe24792df1fbb588184957e2690545e6065
97
17:00:20 PM:
Pushing layer images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj/cache:9cace808fb41dc7e5da295cf073cdbe24792df1fbb588184957e2690545e6065 to cache now
98
17:00:20 PM:
Cmd: USER
99
17:00:20 PM:
USER astro
100
17:00:20 PM:
No files changed in this command, skipping snapshotting.
101
17:00:20 PM:
Taking snapshot of files...
102
17:00:20 PM:
COPY --chown=astro:0 . .
103
17:00:23 PM:
Pushed images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj/cache@sha256:120e26e7d6596146ddeebdadb3e5951ea145a9a5c21b2ffaa52103dd0669774e
104
17:00:23 PM:
Pushing image to images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj:deploy-2025-04-29T08-59-13
105
17:00:32 PM:
Pushed images.astronomer.cloud/cma0updvo1han01hvfybupob8/cma0uusmw1hqq01lgcnhff3mj@sha256:cbbb798993684784d72551146ac93c14a9e692664408358fd55a4a862a97d192
(2)部署成功后 DAG 解析失败
/tmp/airflow/dag_bundles/astro/main/dags/2025-04-29T09:00:36.0994038Z/dags/elt_databricks.py
Timestamp: 2025-04-29, 17:03:54

Traceback (most recent call last):
  File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/operators/databricks_workflow.py", line 31, in <module>
    from airflow.providers.databricks.plugins.databricks_workflow import (
  File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/plugins/databricks_workflow.py", line 26, in <module>
    from flask_appbuilder import BaseView
ModuleNotFoundError: No module named 'flask_appbuilder'
解决方案
https://airflow.apache.org/docs/apache-airflow-providers-fab/stable/index.html
在 requirements.txt 增加依赖库 apache-airflow-providers-fab,安装 apache-airflow-providers-fab 会自动安装 flask-appbuilder 。
apache-airflow-providers-fab==2.0.2
(3)部署成功,但在 Dags 列表中没有显示
解决方案(原理未知)
编辑 Deployment ,将 Executor 从 Celery Executor 改为 Astro Executor,然后操作 “Trigger Git Deploy” 部署一次,Dags 列表中可以显示了。
2. 执行 DAG 出现异常
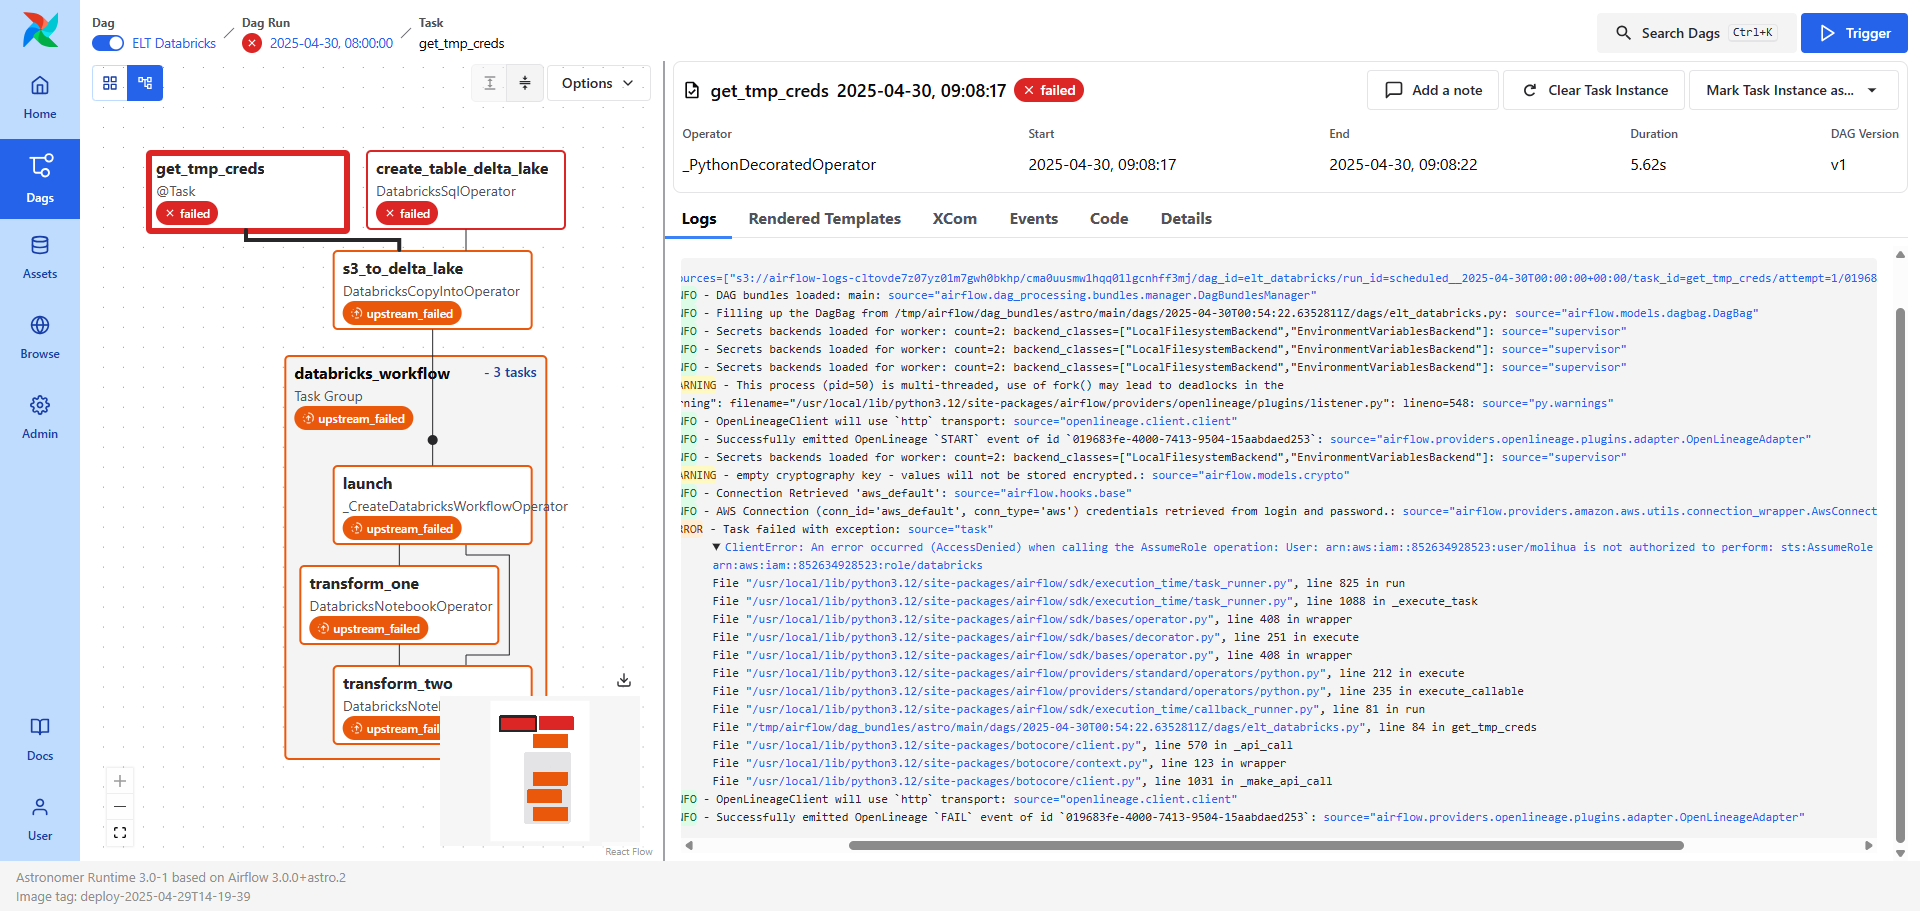
(1)get_tmp_creds 任务日志
[2025-04-30, 09:08:21] INFO - Connection Retrieved 'aws_default': source="airflow.hooks.base"
[2025-04-30, 09:08:21] INFO - AWS Connection (conn_id='aws_default', conn_type='aws') credentials retrieved from login and password.: source="airflow.providers.amazon.aws.utils.connection_wrapper.AwsConnectionWrapper"
[2025-04-30, 09:08:22] ERROR - Task failed with exception: source="task"
ClientError: An error occurred (AccessDenied) when calling the AssumeRole operation: User: arn:aws:iam::852634928523:user/molihua is not authorized to perform: sts:AssumeRole on resource: arn:aws:iam::852634928523:role/databricks
解决方案
给用户增加可以使用访问 S3 定义的角色 的内联策略
{
  "Version": "2012-10-17",
  "Statement": {
    "Effect": "Allow",
    "Action": "sts:AssumeRole",
    "Resource": "arn:aws:iam::852634928523:role/databricks"
  }
}
(2) s3_to_delta_lake 任务日志
[2025-04-30, 09:57:39] ERROR - Task failed with exception: source="task"
DatabricksSqlExecutionError: Error running SQL statement: COPY INTO halloween_candy
FROM 's3://molihua-warehouse/' WITH (CREDENTIAL (AWS_ACCESS_KEY = '***', AWS_SECRET_KEY = '***', AWS_SESSION_TOKEN = '***') )
FILEFORMAT = CSV
FORMAT_OPTIONS ('header' = 'true', 'inferSchema' = 'true')
COPY_OPTIONS ('mergeSchema' = 'true', 'force' = 'true'). s3://molihua-warehouse/: getFileStatus on s3://molihua-warehouse/: com.amazonaws.services.s3.model.AmazonS3Exception: Access to storage destination is denied because of serverless network policy; request: GET http://molihua-warehouse.s3.amazonaws.com  {key=[], key=[false], key=[2], key=[2], key=[/]} Hadoop 3.3.6, aws-sdk-java/1.12.638 Linux/5.15.0-1072-aws OpenJDK_64-Bit_Server_VM/17.0.13+11-LTS java/17.0.13 scala/2.12.15 kotlin/1.9.10 vendor/Azul_Systems,_Inc. cfg/retry-mode/legacy com.amazonaws.services.s3.model.ListObjectsV2Request; Request ID: null, Extended Request ID: null, Cloud Provider: AWS, Instance ID: unknown credentials-provider: com.amazonaws.auth.BasicSessionCredentials credential-header: AWS4-HMAC-SHA256 Credential=***/20250430/us-east-1/s3/aws4_request signature-present: true (Service: Amazon S3; Status Code: 403; Error Code: AccessDenied; Request ID: null; S3 Extended Request ID: null; Proxy: 127.0.0.1), S3 Extended Request ID: null:AccessDenied
ServerOperationError: s3://molihua-warehouse/: getFileStatus on s3://molihua-warehouse/: com.amazonaws.services.s3.model.AmazonS3Exception: Access to storage destination is denied because of serverless network policy; request: GET http://molihua-warehouse.s3.amazonaws.com  {key=[], key=[false], key=[2], key=[2], key=[/]} Hadoop 3.3.6, aws-sdk-java/1.12.638 Linux/5.15.0-1072-aws OpenJDK_64-Bit_Server_VM/17.0.13+11-LTS java/17.0.13 scala/2.12.15 kotlin/1.9.10 vendor/Azul_Systems,_Inc. cfg/retry-mode/legacy com.amazonaws.services.s3.model.ListObjectsV2Request; Request ID: null, Extended Request ID: null, Cloud Provider: AWS, Instance ID: unknown credentials-provider: com.amazonaws.auth.BasicSessionCredentials credential-header: AWS4-HMAC-SHA256 Credential=***/20250430/us-east-1/s3/aws4_request signature-present: true (Service: Amazon S3; Status Code: 403; Error Code: AccessDenied; Request ID: null; S3 Extended Request ID: null; Proxy: 127.0.0.1), S3 Extended Request ID: null:AccessDenied
File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/hooks/databricks_sql.py", line 255 in run

File "/usr/local/lib/python3.12/site-packages/airflow/providers/common/sql/hooks/sql.py", line 629 in _run_command

File "/usr/local/lib/python3.12/site-packages/databricks/sql/client.py", line 812 in execute

File "/usr/local/lib/python3.12/site-packages/databricks/sql/thrift_backend.py", line 926 in execute_command

File "/usr/local/lib/python3.12/site-packages/databricks/sql/thrift_backend.py", line 1018 in _handle_execute_response

File "/usr/local/lib/python3.12/site-packages/databricks/sql/thrift_backend.py", line 834 in _wait_until_command_done

File "/usr/local/lib/python3.12/site-packages/databricks/sql/thrift_backend.py", line 572 in _check_command_not_in_error_or_closed_state
解决方案
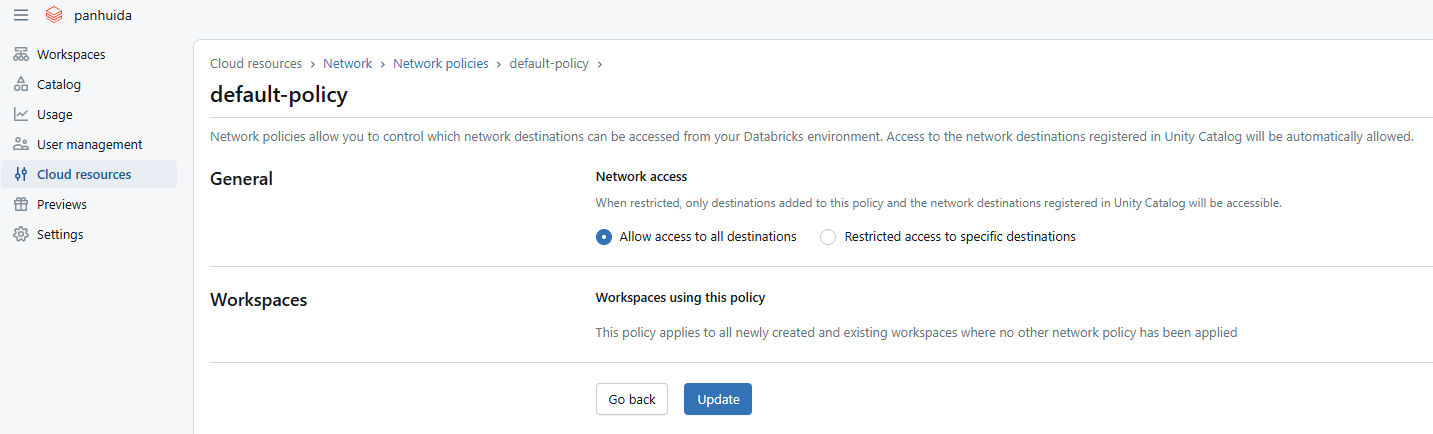
打开 Databricks Account Console ,导航到 “Cloud resources” ,导航到 “Network”,导航到 “Network policies”,将 “default-policy” 中 “Network access” 改为 “Allow access to all destinations” ,取消所有出站限制,这样 Serverless 资源可无限制访问 Internet 和所有存储目标。
(3) databricks_workflow.launch 日志
[2025-04-30, 10:33:28] ERROR - Task failed with exception: source="task"
AirflowException: Response: {"error_code":"INVALID_PARAMETER_VALUE","message":"Only serverless compute is supported in the workspace.","details":[{"@type":"type.googleapis.com/google.rpc.RequestInfo","request_id":"5417ec3f-4caa-4f07-8653-ed1abc2e103c","serving_data":""}]}, Status Code: 400
File "/usr/local/lib/python3.12/site-packages/airflow/sdk/execution_time/task_runner.py", line 825 in run

File "/usr/local/lib/python3.12/site-packages/airflow/sdk/execution_time/task_runner.py", line 1088 in _execute_task

File "/usr/local/lib/python3.12/site-packages/airflow/sdk/bases/operator.py", line 408 in wrapper

File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/operators/databricks_workflow.py", line 202 in execute

File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/operators/databricks_workflow.py", line 179 in _create_or_reset_job

File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/hooks/databricks.py", line 288 in create_job

File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/hooks/databricks_base.py", line 692 in _do_api_call

HTTPError: 400 Client Error: Bad Request for url: https://dbc-482d74e1-ce3e.cloud.databricks.com/api/2.1/jobs/create
File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/hooks/databricks_base.py", line 666 in _do_api_call

File "/usr/local/lib/python3.12/site-packages/tenacity/__init__.py", line 445 in __iter__

File "/usr/local/lib/python3.12/site-packages/tenacity/__init__.py", line 378 in iter

File "/usr/local/lib/python3.12/site-packages/tenacity/__init__.py", line 400 in <lambda>

File "/usr/local/lib/python3.12/concurrent/futures/_base.py", line 449 in result

File "/usr/local/lib/python3.12/concurrent/futures/_base.py", line 401 in __get_result

File "/usr/local/lib/python3.12/site-packages/airflow/providers/databricks/hooks/databricks_base.py", line 685 in _do_api_call

File "/usr/local/lib/python3.12/site-packages/requests/models.py", line 1024 in raise_for_status
解决方案
https://chatgpt.com/c/681184e3-b004-8012-bc89-9e67deeb6d05
当前的 Databricks 工作区 是一个 Serverless Workspace,所有计算都由无服务器计算(Serverless Compute)提供,不允许创建或使用自定义集群 。
修改 DAG 代码 elt_databricks.py ,使用 Serverless Compute 提交模式,即去掉自定义集群的代码,系统将 自动采用 Serverless Compute 来运行任务。
**(4)执行 Databricks 上的 candy_notebook_1 出现异常 **
databricks_workflow.transform_one 的日志详细的错误日志,需要在 Databricks 上去看
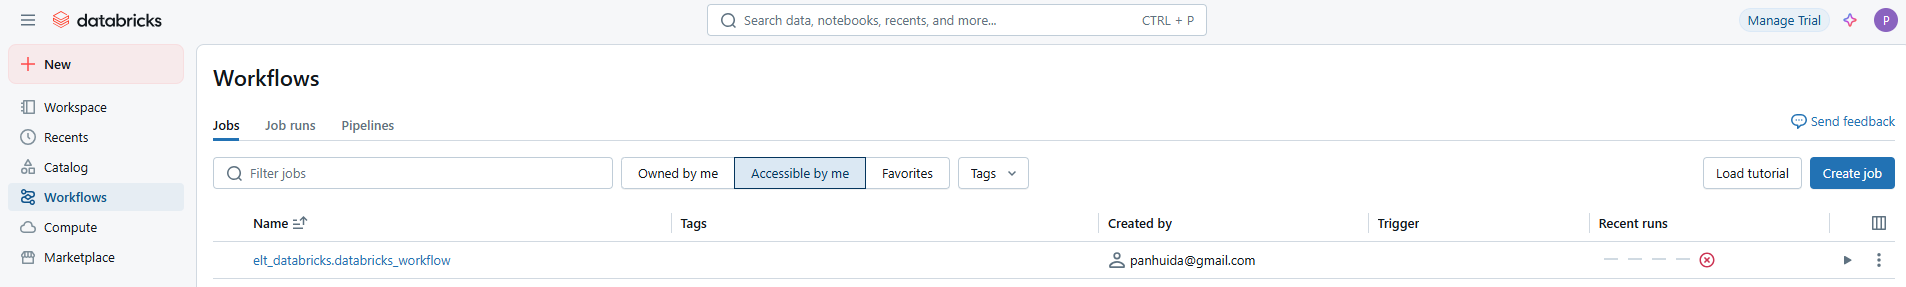
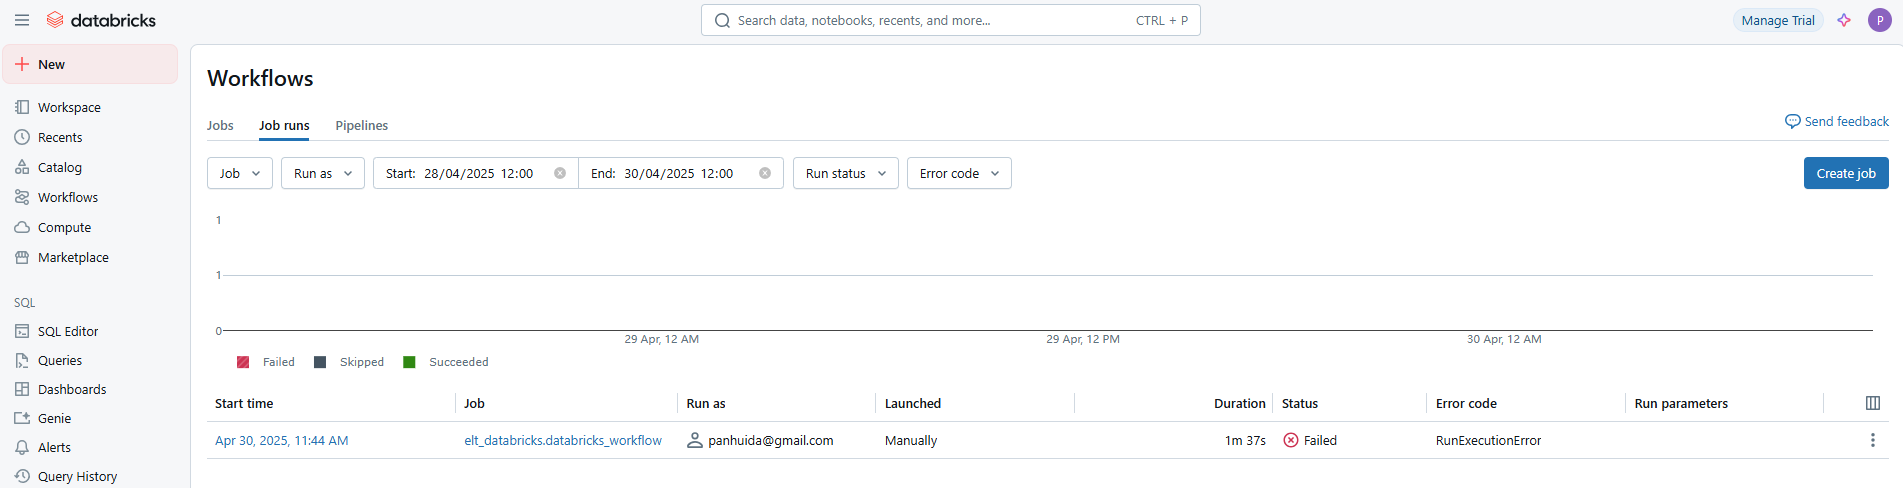
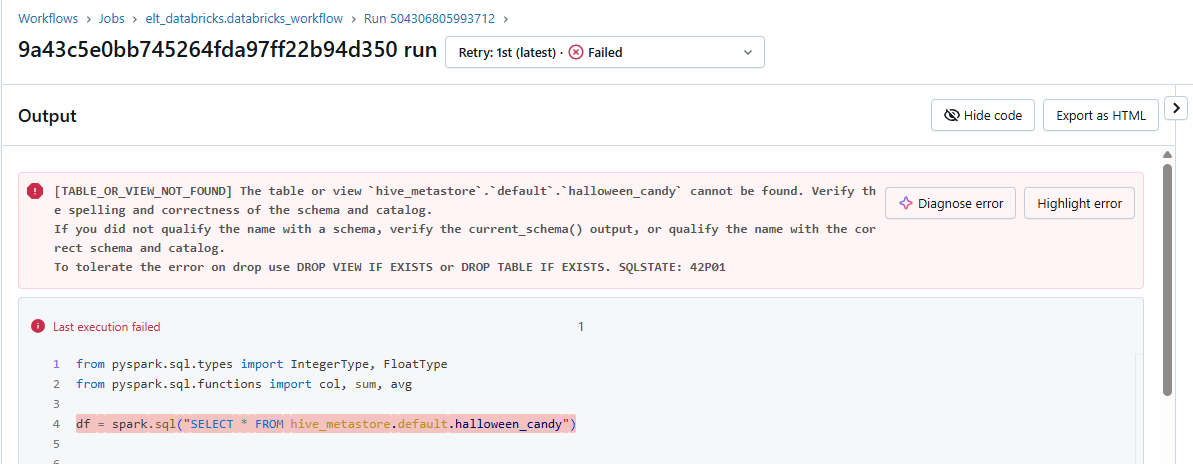
解决方案
在 Databricks 中,修改 candy_notebook_1 的代码,修改数据表的路径(可以搜索数据表,查看数据表的元数据获取)。
06 参考资料
1. ELT for Beginners: Extract from S3, Load to Databricks and Run Transformations
2. IAM 教程:使用 IAM 角色委托跨 AWS 账户的访问权限
https://docs.aws.amazon.com/zh_cn/IAM/latest/UserGuide/tutorial_cross-account-with-roles.html
3. Apache Airflow 3 is Generally Available
https://airflow.apache.org/blog/airflow-three-point-oh-is-here/