数据工程新手项目 - 流处理版本 - Kafka、RisingWave、Superset、Qwen3
数据工程新手项目 - 流处理版本 - Kafka、RisingWave、Superset、Qwen3 练习记录
之前找了一个批处理的项目练习(数据工程新手项目 - 批处理版本),这次找了一个流处理项目练习。
01 介绍
本文记录的是基于 Wikipedia、 Kafka、RisingWave、Superset,开发流式数据管道 ( Streaming Data Pipeline) 和搭建数据看板,用于了解和分析维基百科新建文章(条目)的情况。在数据管道中,也尝试使用 Qwen3 的量化模型翻译维基百科上各种语言的文章标题。
RisingWave 是一个与 PostgreSQL 兼容的流数据库(兼容程度在生产环境使用需要评估)。
使用 RisingWave ,与 Flink / Spark Streaming + Paimon/ Iceberg / Doris / StarRocks 方案相比,在有些场景下,确实简化了技术栈和有着更好的易用性( Doris / StarRocks 可能也会增加 Kafka connector 的功能 )。
本文的源码仓库
https://github.com/panhuida/dp
这次练习参考的原文链接(参考资料[1] )
https://mp.weixin.qq.com/s/5Pj0kSVKQnxjlSuA-1WoSw
02 架构
1. 整体的架构及数据流图
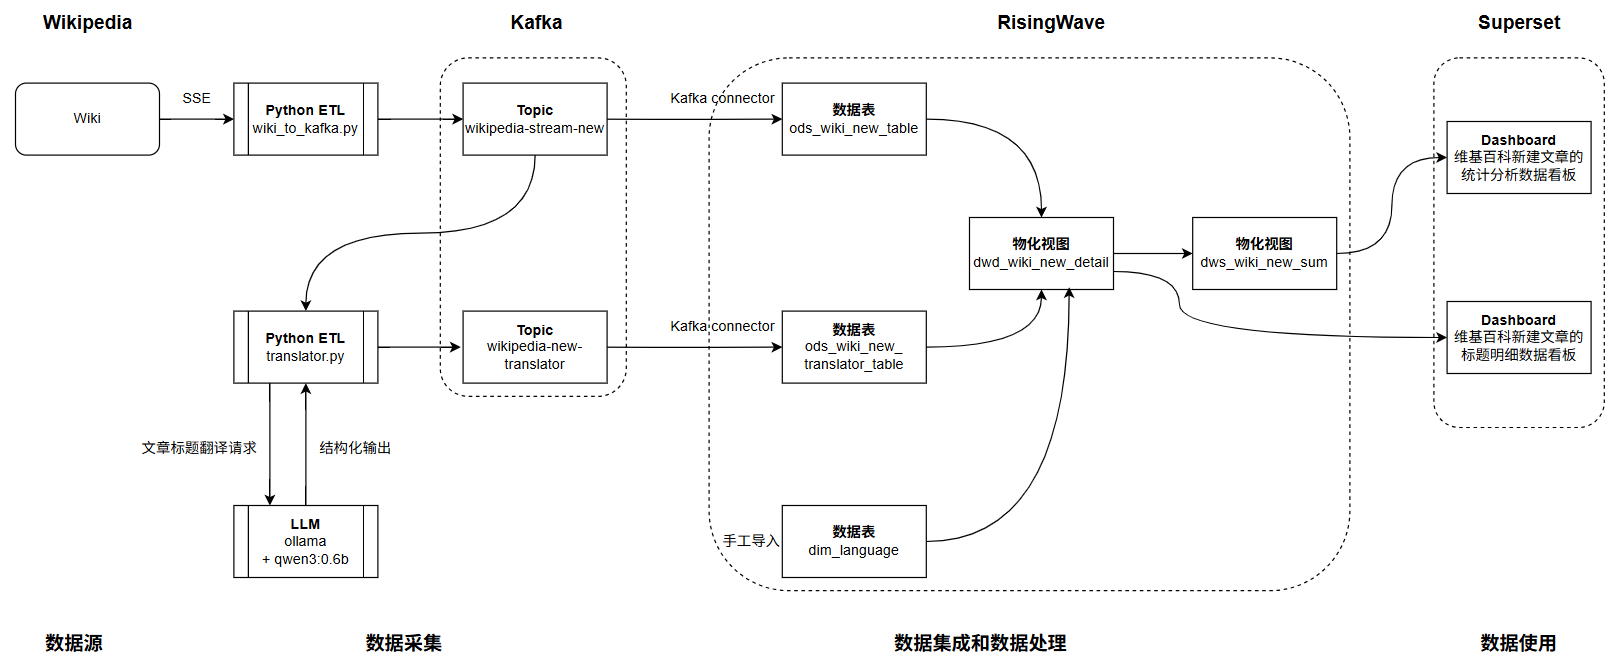
按实时数仓的方式设计,从分层来看,分为ODS、DW两层(离线数仓建议还是要分 ODS、DW、ADS 三层),DW包含DWD、DWS(考虑整个链路的时效性);从模型设计来看,采用了核心模型、扩展模型分离的原则,即将维基百科的文章标题翻译采取单独的处理链路实现(异步)。
整个链路,分为数据采集和前置数据处理(数据采集)、数仓ETL(数据集成和数据处理)、数据可视化(数据使用)。
(1)数据采集和前置数据处理
使用 Python ETL 脚本 ( wiki_to_kafka.py ) 从 Wikipedia API 获取实时数据,取到新增的维基百科文章(条目)的标题、贡献者的信息,写入 Kafka Topic ( wikipedia-stream-new ) 。
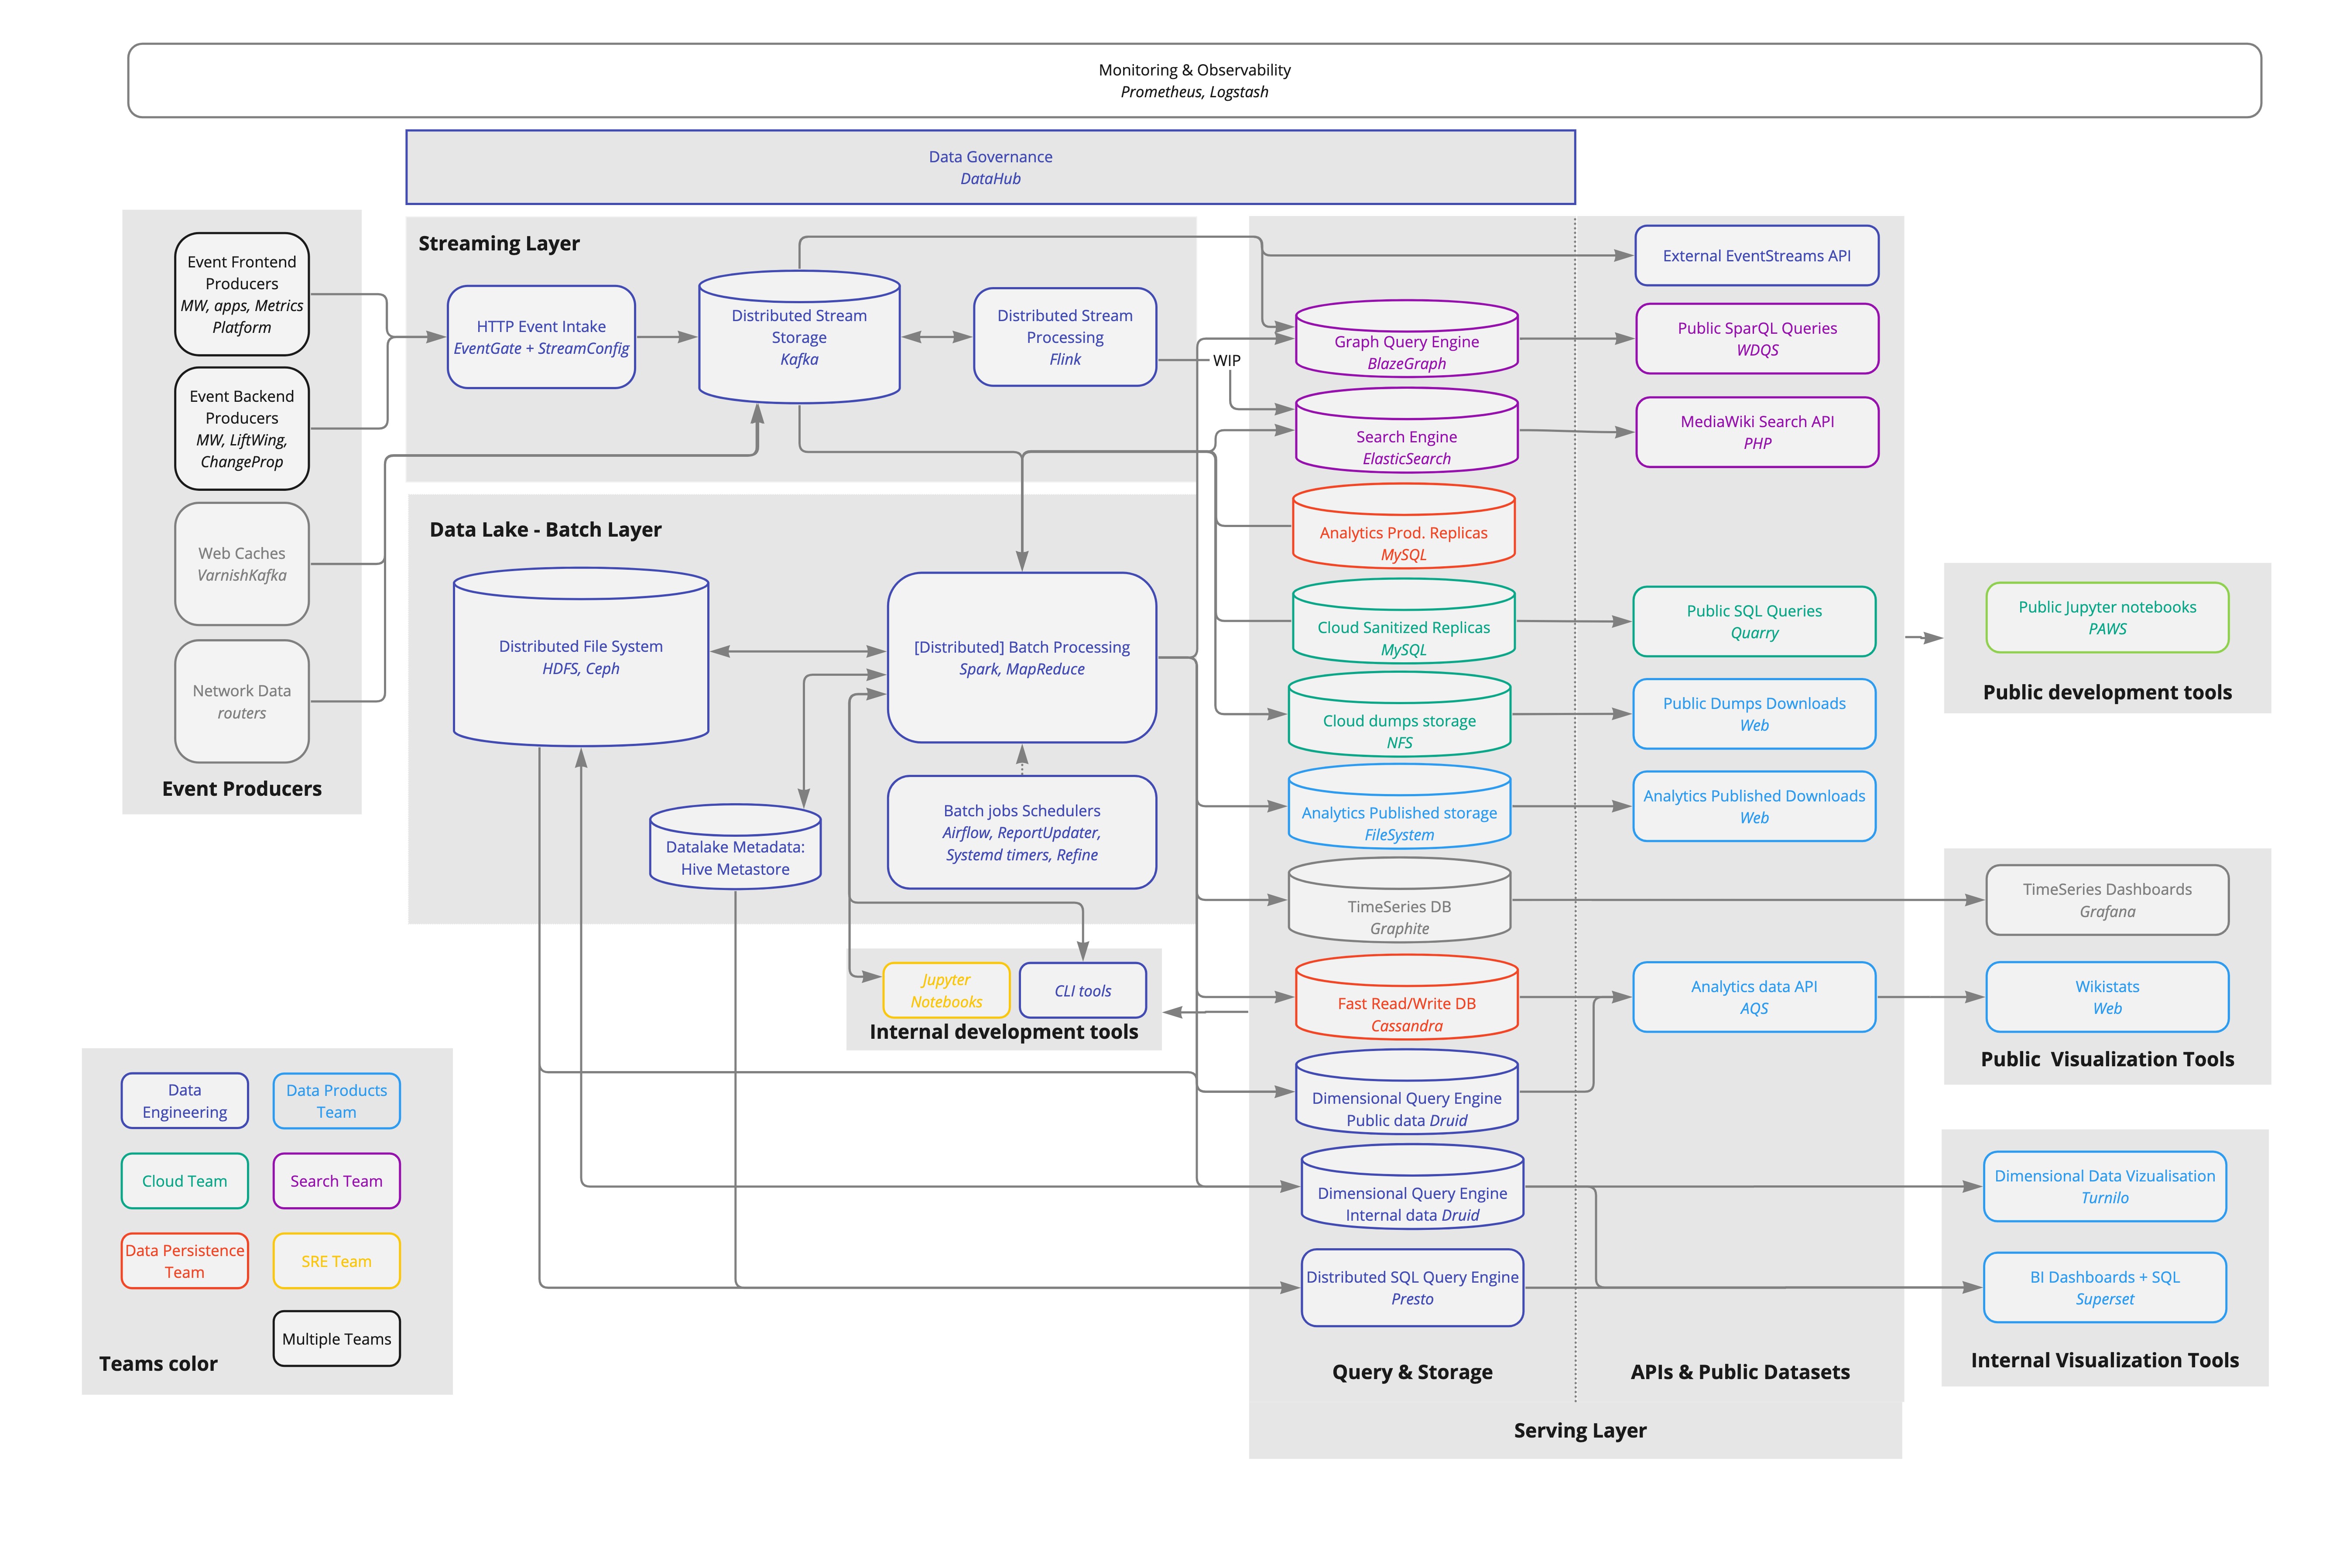
注: Wikipedia API ,背后也是使用数据平台提供的数据服务,详见参考资料[2] 中的Data Platform Technical Overview 架构图
使用 Python ETL 脚本 ( translator.py ) 消费 Kafka Topic ( wikipedia-stream-new ) 的数据,取到新增的维基百科文章(条目)的标题,调用 ollama API 使用 Qwen3 6b 翻译标题,将翻译结果写入 Kafka Topic ( wikipedia-new-translator ) 。
(2)数仓ETL
在 RisingWave 中,创建 ODS 层数据表,使用 Kafka connector 将 Kafka 的数据实时同步到 ODS 层数据表;
对于维表,编写 Python 脚本,使用 RisingWave Python SDK 手工导入;
DW 层,使用 物化视图 实现。
(3)数据可视化
最后,在 Superset,搭建数据看板。
03 操作步骤
1. 安装 Kafka
安装最新版本 kafka 4.0.0,这个版本正式去掉了对 zookeeper 的依赖。
https://kafka.apache.org/downloads
https://kafka.apache.org/blog#apache_kafka_400_release_announcement
https://dlcdn.apache.org/kafka/4.0.0/RELEASE_NOTES.html
https://www.confluent.io/installation/
# 下载并校验
pan@pan-SER8:/opt/kafka$ sha512sum kafka_2.13-4.0.0.tgz
00722ab0a6b954e0006994b8d589dcd8f26e1827c47f70b6e820fb45aa35945c19163b0f188caf0caf976c11f7ab005fd368c54e5851e899d2de687a804a5eb9  kafka_2.13-4.0.0.tgz


# STEP 1: GET KAFKA
https://kafka.apache.org/downloads
pan@pan-SER8:/opt/kafka$ tar -zxvf kafka_2.13-4.0.0.tgz
pan@pan-SER8:/opt/kafka$ tar -zxvf kafka_2.13-4.0.0.tgz


# STEP 2: START THE KAFKA ENVIRONMENT
# 安装 Java 17
迷你主机中已经安装了 Java 17

# Generate a Cluster UUID
pan@pan-SER8:/opt/kafka/kafka_2.13-4.0.0$ KAFKA_CLUSTER_ID="$(bin/kafka-storage.sh random-uuid)"

# Format Log Directories
pan@pan-SER8:/data$ mkdir -p kafka/kraft-combined-logs
pan@pan-SER8:/opt/kafka/kafka_2.13-4.0.0$ vim config/server.properties
log.dirs=/data/kafka/kraft-combined-logs
pan@pan-SER8:/opt/kafka/kafka_2.13-4.0.0$ bin/kafka-storage.sh format --standalone -t $KAFKA_CLUSTER_ID -c config/server.properties
Formatting dynamic metadata voter directory /data/kafka/kraft-combined-logs with metadata.version 4.0-IV3.

# 访问配置
pan@pan-SER8:/opt/kafka/kafka_2.13-4.0.0$ vim config/server.properties
advertised.listeners=PLAINTEXT://192.168.31.72:9092,CONTROLLER://192.168.31.72:9093

# Start the Kafka Server
pan@pan-SER8:/opt/kafka/kafka_2.13-4.0.0$ bin/kafka-server-start.sh config/server.properties
[2025-05-10 15:38:12,536] INFO [BrokerServer id=1] Transition from STARTING to STARTED (kafka.server.BrokerServer)
[2025-05-10 15:38:12,537] INFO [KafkaRaftServer nodeId=1] Kafka Server started (kafka.server.KafkaRaftServer)
2. 安装 RisingWave
查看之前的文章《在本地搭建 Data Lakehouse 测试、学习环境》
或者参考官方文档
https://docs.risingwave.com/get-started/quickstart
# curl -L https://risingwave.com/sh | sh
pan@pan-SER8:/opt/risingwave$ wget https://raw.githubusercontent.com/risingwavelabs/risingwave/main/scripts/install/install-risingwave.sh
# 默认是最新的版本,修改为v2.2.4
pan@pan-SER8:/opt/risingwave$ vim install-risingwave.sh
VERSION="v2.2.4"
pan@pan-SER8:/opt/risingwave$ sh install-risingwave.sh
pan@pan-SER8:/opt/risingwave$ ./risingwave

# 访问
pan@pan-SER8:/opt/risingwave$ psql -h 0.0.0.0 -p 4566 -d dev -U root
3. 安装 Superset
查看之前的文章《在本地搭建 Data Lakehouse 测试、学习环境》
4. 使用 Python 进行数据采集和前置数据处理
编写 Python 程序,从维基百科的接口获取数据,发送到Kafka;
对于数据中文章标题字段(各种语言),调用本地的ollama接口,使用 LLM qwen3 6b 模型进行翻译,翻译接口发送到 Kafka。
(1)了解维基百科的接口及数据
解维基百科的接口 event schema
https://schema.wikimedia.org/repositories/primary/jsonschema/mediawiki/recentchange/current.yaml
https://stream.wikimedia.org/v2/stream/recentchange 示例数据
事件类型: new
data: {
"$schema": "/mediawiki/recentchange/1.0.0",
"meta": {
"uri": "https://commons.wikimedia.org/wiki/Category:Number_3183_on_buses",
"request_id": "0be01d56-4857-48ec-a957-fce94cf63297",
"id": "35e28ca5-5fda-4eb8-a907-a28b2c9beabf",
"dt": "2025-05-10T10:27:42Z",
"domain": "commons.wikimedia.org",
"stream": "mediawiki.recentchange",
"topic": "eqiad.mediawiki.recentchange",
"partition": 0,
"offset": 5576636114
},
"id": 2850009879,
"type": "new",
"namespace": 14,
"title": "Category:Number 3183 on buses",
"title_url": "https://commons.wikimedia.org/wiki/Category:Number_3183_on_buses",
"comment": "# Cat.",
"timestamp": 1746872862,
"user": "UgoEmme",
"bot": false,
"notify_url": "https://commons.wikimedia.org/w/index.php?oldid=1030331991&rcid=2850009879",
"minor": false,
"patrolled": false,
"length": {
"new": 29
},
"revision": {
"new": 1030331991
},
"server_url": "https://commons.wikimedia.org",
"server_name": "commons.wikimedia.org",
"server_script_path": "/w",
"wiki": "commonswiki",
"parsedcomment": "# Cat."
}
事件类型: edit
data: {
"$schema": "/mediawiki/recentchange/1.0.0",
"meta": {
"uri": "https://www.wikidata.org/wiki/Q125624736",
"request_id": "ea907a7e-2169-404d-8f37-c84b28aa187d",
"id": "7384c52a-59d6-482e-97b5-f6a5560a483a",
"dt": "2025-05-10T09:57:26Z",
"domain": "www.wikidata.org",
"stream": "mediawiki.recentchange",
"topic": "eqiad.mediawiki.recentchange",
"partition": 0,
"offset": 5576590506
},
"id": 2418341771,
"type": "edit",
"namespace": 0,
"title": "Q125624736",
"title_url": "https://www.wikidata.org/wiki/Q125624736",
"comment": "/* wbsetdescription-add:1|ja */ バドミントン選手, [[:toollabs:quickstatements/#/batch/246199|batch #246199]]",
"timestamp": 1746871046,
"user": "Florentyna",
"bot": false,
"notify_url": "https://www.wikidata.org/w/index.php?diff=2346932711&oldid=2346719313&rcid=2418341771",
"minor": false,
"patrolled": true,
"length": {
"old": 33283,
"new": 33366
},
"revision": {
"old": 2346719313,
"new": 2346932711
},
"server_url": "https://www.wikidata.org",
"server_name": "www.wikidata.org",
"server_script_path": "/w",
"wiki": "wikidatawiki",
"parsedcomment": "<span dir=\"auto\"><span class=\"autocomment\">Added [ja] description: </span></span> バドミントン選手, <a href=\"https://iw.toolforge.org/quickstatements/#.2Fbatch.2F246199\" class=\"extiw\" title=\"toollabs:quickstatements/\">batch #246199</a>"
}
Wikipedia 的 timestamp 是 Unix 时间戳 (秒),meta.dt 是 ISO 8601 格式,如 “2023-12-03T18:23:02Z”,后面用的是timestamp字段。
(2)使用 Python 获取维基百科数据写入 Kafka
https://claude.ai/chat/2b53d15a-6649-4760-9177-0952e70638d1
https://gemini.google.com/app/17c58f30ecd86d02
运行环境
pan@pan-SER8:/opt/code/dp/risingwave$ source /opt/jupyter/bin/activate
(jupyter) pan@pan-SER8:/opt/code/dp/risingwave$ pip install sseclient-py confluent-kafka requests
源码 wiki_to_kafka.py
import json
import logging
import time
from datetime import datetime
import re

import requests
import sseclient
from confluent_kafka import Producer
from requests.exceptions import RequestException
from urllib.parse import unquote


# 配置日志
logging.basicConfig(
    level=logging.INFO,
    format='%(asctime)s - %(name)s - %(levelname)s - %(message)s',
    filename='etl_wiki_to_kafka.log',
    filemode='a'
)
logger = logging.getLogger(__name__)

# 配置参数
# Wikipedia事件流 URL
WIKIPEDIA_SSE_URL = "https://stream.wikimedia.org/v2/stream/recentchange"
# Kafka
KAFKA_BOOTSTRAP_SERVERS = "192.168.31.72:9092"
KAFKA_TOPIC = "wikipedia-stream-new"
# 重连等待时间(秒)
RECONNECT_DELAY_SECONDS = 10

# 编译正则表达式
pattern = re.compile(r'^https:\/\/(\w+)\.wikipedia\.org\/wiki\/[^:]+$')


def delivery_report(err, msg):
    """Kafka 消息发送回调函数"""
    if err is not None:
        logger.error(f"消息发送失败到 {msg.topic()}: {err}")
    # else:
    #     logger.debug(f"消息已发送到: {msg.topic()} [{msg.partition()}] @ {msg.offset()}")


def setup_kafka_producer():
    """ 设设置并返回 Kafka 生产者实例 """
    # Confluent Kafka Producer配置
    conf = {
        'bootstrap.servers': KAFKA_BOOTSTRAP_SERVERS,
        'client.id': 'wikipedia-stream-producer'
    }
    try:
        producer = Producer(conf)
        logger.info(f"Kafka 生产者已连接到 {KAFKA_BOOTSTRAP_SERVERS}")
        return producer
    except Exception as e:
        logger.error(f"连接 Kafka 失败: {e}", exc_info=True) # exc_info=True 打印堆栈信息
        # 重新抛出异常,让主函数处理
        raise


def process_single_event(event_data, producer):
    """ 处理单个 Wikipedia 事件数据,构建 Kafka 消息并发送 """
    try:
        # 仅处理 'new' 或 'edit' 类型的事件
        event_type = event_data.get('type')
        # if event_type not in ('new', 'edit'):
        if event_type not in ('new'):
            # logger.debug(f"跳过非编辑/新建事件类型: {event_type}") # 可选的调试日志
            return

        event_id = event_data.get('id')
        event_title = event_data.get('title')
        event_title_url = event_data.get('title_url')
        event_user = event_data.get('user')
        event_timestamp = event_data.get('timestamp')

        # 处理标题 URL
        # 维基百科的标题 URL 格式为 https://<language>.wikipedia.org/wiki/<title>
        title_url_match = re.fullmatch(pattern, event_title_url)
        if title_url_match is None:
            return # 如果 URL 不符合维基百科格式,则跳过此消息
        formatted_title_url = unquote(event_title_url) # 解码 URL 中的 %20 等编码

        # 处理时间戳
        # Wikipedia 的 timestamp 是 Unix 时间戳 (秒)
        try:
            formatted_timestamp = datetime.fromtimestamp(event_timestamp).strftime("%Y-%m-%d %H:%M:%S")
        except Exception as e:
            logger.warning(f"无法为事件 (ID: {event_id}) 解析时间戳 (值: {event_timestamp}),跳过发送。错误: {e}")
            return # 如果时间戳解析失败,则不发送此消息

        # 构建Kafka消息(根据业务需求提取和转换字段)
        message = {
            "id": event_id, # 事件ID
            "opt_type": event_type, # 操作类型 (new/edit)
            "title": event_title, # 页面标题
            "title_url": formatted_title_url, # 页面 URL
            "opt_time": formatted_timestamp, # 操作时间 (格式化字符串)
            "contributor": event_user, # 贡献者 (用户名或IP)
            # 根据原始代码逻辑,这些字段设置为默认值,不再从其他API获取详细信息
            "registration": None,
            "gender": "unknown",
            "edit_count": "0"
        }

        # 序列化消息为 JSON 字符串
        message_json = json.dumps(message, ensure_ascii=False).encode('utf-8') # ensure_ascii=False 保留非ASCII字符

        # 发送到 Kafka
        # 注意: produce 是异步操作
        producer.produce(
            KAFKA_TOPIC,
            value=message_json,
            callback=delivery_report # 设置回调函数处理发送结果
        )
        # 处理回调 (非阻塞,立即检查是否有已完成的发送)
        producer.poll(0)

    except Exception as e:
        # 捕获处理单个事件时的任何其他异常
        # 这里的异常仅影响单个消息,不中断流处理循环
        logger.error(f"处理事件失败 (原始数据可能包含于日志上下文): {e}", exc_info=True)


def process_wikipedia_stream(producer):
    """ 从 Wikipedia EventStreams 获取数据并将其发送到 Kafka, 包含自动重连逻辑 """
    logger.info("尝试连接 Wikipedia 编辑流...")
    response = None # Initialize response outside the try block
    client = None # Initialize client outside the try block

    while True: # 无限循环尝试重连
        try:
            headers = {'Accept': 'text/event-stream'}
            # 设置合理的连接和读取超时
            response = requests.get(WIKIPEDIA_SSE_URL, stream=True, headers=headers, timeout=(10, 30))
            # 检查 HTTP 响应状态码,如果不是 2xx 则抛出异常
            response.raise_for_status()

            client = sseclient.SSEClient(response)

            logger.info("成功连接到 Wikipedia 编辑流,开始处理事件...")

            # 遍历 EventStreams 的事件
            # 如果连接中断或出错,client.events() 会抛出 StopIteration 或其他异常
            for event in client.events():
                if event.event == 'message' and event.data: # 仅处理 message 类型的事件且确保有数据
                    try:
                        # EventStreams 的 data 字段是 JSON 字符串
                        event_data = json.loads(event.data)
                        process_single_event(event_data, producer) # 调用处理单个事件的 helper

                    except json.JSONDecodeError:
                       # 解析错误不应中断整个流,只记录并继续
                        logger.error("接收到无效的 JSON 数据,无法解析。")


        except RequestException as e:
            # 处理 requests 相关的错误 (连接失败, 读取超时, HTTP 状态码错误等)
            logger.error(f"连接或读取 Wikipedia EventStreams 失败: {e}", exc_info=True)
            logger.info(f"等待 {RECONNECT_DELAY_SECONDS} 秒后尝试重新连接...")
            time.sleep(RECONNECT_DELAY_SECONDS)

        except Exception as e:
            # 捕获处理流过程中可能发生的其他未知异常
            logger.error(f"处理 Wikipedia EventStreams 过程中发生未知错误: {e}", exc_info=True)
            logger.info(f"等待 {RECONNECT_DELAY_SECONDS} 秒后尝试重新连接...")
            time.sleep(RECONNECT_DELAY_SECONDS)

        finally:
            # 确保在循环重试或退出前关闭响应
            if response:
                try:
                    response.close()
                    logger.debug("已关闭 SSE 响应连接。")
                except Exception as e:
                     logger.warning(f"关闭 SSE 响应连接时发生错误: {e}")


def main():
    """ 主函数:初始化 Kafka 生产者并启动流处理 """
    kafka_producer = None # 在 try 块外部初始化为 None
    try:
        kafka_producer = setup_kafka_producer()
        # 启动包含重连逻辑的流处理
        process_wikipedia_stream(kafka_producer)
    except KeyboardInterrupt:
        logger.info("程序被用户中断 (KeyboardInterrupt)")
    except Exception as e:
        # 捕获 setup_kafka_producer 或 process_wikipedia_stream 中未处理的异常
        logger.error(f"程序因未处理的异常退出: {e}", exc_info=True)
    finally:
        # 确保在程序退出前关闭 Kafka 生产者并 flush 所有消息
        if kafka_producer:
            logger.info("正在关闭 Kafka 生产者并刷新剩余消息...")
            # flush() 阻塞直到所有排队消息被发送,添加超时参数
            try:
                kafka_producer.flush(timeout=15) # 设置一个合理的超时时间 (秒)
                logger.info("Kafka 生产者已成功刷新并关闭。")
            except Exception as e:
                logger.error(f"Kafka 生产者刷新或关闭时发生错误: {e}", exc_info=True)


if __name__ == "__main__":
    main()
(3)使用 Python 调用 Ollama API 翻译文章标题并将结果写入 Kafka
translator.py
import json
import logging
import time
from datetime import datetime

import requests # 用于Ollama API调用
from confluent_kafka import Consumer, Producer, KafkaException


# 配置日志
logging.basicConfig(
    level=logging.INFO,
    format='%(asctime)s - %(name)s - %(levelname)s - %(message)s',
    filename='etl_translator.log',
    filemode='a'
)
logger = logging.getLogger(__name__)

# 配置参数
# Kafka
KAFKA_BOOTSTRAP_SERVERS = "192.168.31.72:9092"
SOURCE_KAFKA_TOPIC = "wikipedia-stream-new"
TARGET_KAFKA_TOPIC = "wikipedia-new-translator"
CONSUMER_GROUP_ID = "wikipedia-new-translator-group"

# Ollama
OLLAMA_API_URL = "http://192.168.31.72:11434/api/generate"
OLLAMA_MODEL = "qwen3:0.6b"

# 重试
KAFKA_RETRY_DELAY_SECONDS = 10
OLLAMA_RETRY_DELAY_SECONDS = 3
MAX_OLLAMA_RETRIES = 3


def delivery_report(err, msg):
    """ Kafka 消息发送回调函数 """
    if err is not None:
        logger.error(f"消息发送失败到 {msg.topic()}: {err}")
    else:
        logger.debug(f"消息已发送到: {msg.topic()} [{msg.partition()}] @ {msg.offset()}")


def setup_kafka_consumer():
    """ 设置并返回 Kafka 消费者实例 """
    conf = {
        'bootstrap.servers': KAFKA_BOOTSTRAP_SERVERS,
        'group.id': CONSUMER_GROUP_ID,
        'auto.offset.reset': 'earliest',  # 如果没有存储偏移量,则从最早的开始读取
        'enable.auto.commit': False,      # 后面手动提交偏移量
    }
    try:
        consumer = Consumer(conf)
        consumer.subscribe([SOURCE_KAFKA_TOPIC])
        logger.info(f"Kafka 消费者已订阅主题 {SOURCE_KAFKA_TOPIC},消费者组为 {CONSUMER_GROUP_ID}")
        return consumer
    except KafkaException as e:
        logger.error(f"创建 Kafka 消费者失败: {e}", exc_info=True)
        raise


def setup_kafka_producer():
    """ 设置并返回 Kafka 生产者实例 """
    conf = {
        'bootstrap.servers': KAFKA_BOOTSTRAP_SERVERS,
        'client.id': 'wikipedia-translator-producer',
    }
    try:
        producer = Producer(conf)
        logger.info(f"Kafka 生产者已连接到 {KAFKA_BOOTSTRAP_SERVERS}")
        return producer
    except KafkaException as e:
        logger.error(f"创建 Kafka 生产者失败: {e}", exc_info=True)
        # 重新抛出异常,让主函数处理
        raise


def translate_text_with_ollama(text_to_translate):
    """ 使用 Ollama API 和指定模型将文本翻译成中文 """
    if not text_to_translate:
        logger.warning("收到空文本进行翻译,返回空字符串。")
        return ""

    # 为qwen模型构建一个更直接的翻译提示
    prompt = f"请将以下内容翻译成中文,把原文和翻译结果分别保存在 'source_text' 和 'target_text' 字段,以 JSON 格式输出: {text_to_translate}"

    # 结构化输出
    payload = {
        "model": OLLAMA_MODEL,
        "prompt": prompt,
        "stream": False, # 我们需要一次性获得完整响应
        "options": {
            "temperature": 0.1
        },
        "format": {
            "type": "object",
            "properties": {
            "source_text": {
                "type": "string"
            },
            "target_text": {
                "type": "string"
            }
            },
            "required": [
            "source_text",
            "target_text"
            ]
        }
    }

    headers = {"Content-Type": "application/json"}

    retries = 0
    response_json = None
    while retries < MAX_OLLAMA_RETRIES:
        try:
            response = requests.post(OLLAMA_API_URL, json=payload, headers=headers, timeout=60)
            # 对HTTP错误抛出异常
            response.raise_for_status()

            response_json = response.json()

            # 模型的回答部分
            response_field = response_json.get("response")

            try:
                response_field_json = json.loads(response_field)

                # 现在 translated_data 应该是一个字典,从中获取 target_text
                translated_text = response_field_json.get("target_text", "").strip()

                # 验证 extracted data
                if not translated_text:
                     logger.warning(f"从 Ollama 响应中提取的 'target_text' 为空或缺失。模型返回: {response_json}")
                     return ""

                # 获取翻译结果
                translated_text = response_field_json.get("target_text", "").strip()
                # logger.info(f"翻译 '{text_to_translate}' 成功,翻译结果: {translated_text},模型返回: {response_json}")
                return translated_text

            except json.JSONDecodeError as e:
                 logger.error(f"解析 Ollama 'response' 字段内的 JSON 字符串失败: {response_field}. 错误: {e}. ", exc_info=True)
                 # 解析内部 JSON 失败,也进行重试
                 if retries < MAX_OLLAMA_RETRIES - 1 :
                    retries += 1
                    logger.info(f"由于解析内部 JSON 错误,将在 {OLLAMA_RETRY_DELAY_SECONDS * retries} 秒后重试 (尝试 {retries+1}/{MAX_OLLAMA_RETRIES})...")
                    time.sleep(OLLAMA_RETRY_DELAY_SECONDS * retries)
                    continue # 继续下一次循环尝试重试
                 else:
                    logger.error(f"已达到 Ollama API 的最大重试次数,解析内部 JSON 持续错误。翻译 '{text_to_translate}' 失败。")
                    return "" # 返回空字符串表示翻译失败

        except requests.exceptions.RequestException as e:
            retries += 1
            logger.error(f"调用 Ollama API 出错 (尝试 {retries}/{MAX_OLLAMA_RETRIES}): {e}", exc_info=False) # exc_info=False 避免重复打印堆栈
            if retries >= MAX_OLLAMA_RETRIES:
                logger.error(f"已达到 Ollama API 的最大重试次数。翻译 '{text_to_translate}' 失败。")
                return ""
            time.sleep(OLLAMA_RETRY_DELAY_SECONDS * retries) # 增加重试等待时间


        except Exception as e:
            logger.error(f"Ollama 翻译 '{text_to_translate}' 过程中发生意外错误: {e}", exc_info=True)
            logger.info(f"response_field: {response_field}, response_field_json: {response_field_json}, translated_text: {translated_text}")

            # 对于未知错误,也进行重试
            if retries < MAX_OLLAMA_RETRIES - 1 :
                retries += 1
                logger.info(f"由于意外错误,将在 {OLLAMA_RETRY_DELAY_SECONDS * retries} 秒后重试 (尝试 {retries+1}/{MAX_OLLAMA_RETRIES})...")
                time.sleep(OLLAMA_RETRY_DELAY_SECONDS * retries)
                continue
            else:
                logger.error(f"最大重试次数后,仍然遇到意外错误。")
                return ""

    return "" # 如果所有重试都失败


def process_messages(consumer, producer):
    """ 消费消息,翻译标题,并发送到新的 topic """
    logger.info("启动消息处理循环...")
    try:
        while True:
            msg = consumer.poll(timeout=1.0)  # 轮询消息,超时时间为1秒
            if msg is None:
                continue
            if msg.error():
                logger.error(f"Kafka 消费者错误: {msg.error()}", exc_info=True)
                # 如果是可恢复的错误,可以添加延迟重试
                time.sleep(KAFKA_RETRY_DELAY_SECONDS)
                continue
            try:
                # 解码消息值
                message_json = json.loads(msg.value().decode('utf-8'))
                # logger.info(f"接收到消息: {message_json}")
                event_title = message_json.get('title')

                if not event_title:
                    logger.warning(f"消息值中没有 'title' 字段,跳过翻译。消息: {message_json}")
                    consumer.commit(message=msg) # 提交偏移量
                    continue

                # 翻译标题
                translated_title = translate_text_with_ollama(event_title)

                # 创建新的消息
                # 在原始消息的'value'部分添加翻译后的标题为'title_zh',并保留原始标题和其他所有字段
                new_event_data = message_json.copy() # 复制原始事件数据以进行修改
                new_event_data["title_zh"] = translated_title
                new_event_data["translated_at"] = datetime.now().strftime("%Y-%m-%d %H:%M:%S")

                message_json_producer = json.dumps(new_event_data, ensure_ascii=False).encode('utf-8')

                # 发送到 Kafka
                producer.produce(
                    TARGET_KAFKA_TOPIC,
                    value=message_json_producer,
                    callback=delivery_report
                )
                # 注意:这里只实现了 "at-most-once"(最多一次)的语义
                # producer.produce() 成功将消息放入生产者内部队列,但在 Kafka Broker 实际确认收到消息之前,消费者对原始输入消息的偏移量就已经被提交了
                # 处理回调 (非阻塞,立即检查是否有已完成的发送)
                producer.poll(0)
                # 提交偏移量
                consumer.commit(message=msg)
                logger.debug(f"提交了偏移量为 {msg.offset()} 的消息")

            except json.JSONDecodeError as e:
                logger.error(f"解码JSON消息失败: {msg.value().decode('utf-8')}. 错误: {e}", exc_info=True)
                # 决定如何处理:跳过,发送到死信队列等。
                # 避免重复处理格式错误的消息
                consumer.commit(message=msg)
            except Exception as e:
                logger.error(f"处理消息时发生错误: {msg.value().decode('utf-8')}. 错误: {e}", exc_info=True)
                consumer.commit(message=msg)

    except KeyboardInterrupt:
        logger.info("消费者进程被用户中断 (KeyboardInterrupt)。")
    except Exception as e:
        logger.error(f"消息处理循环中发生未处理的异常: {e}", exc_info=True)
    finally:
        logger.info("正在关闭 Kafka 消费者。")
        if consumer: # 确保consumer已初始化
            consumer.close()


# 主函数
def main():
    """ 主函数:初始化并启动翻译服务 """
    kafka_consumer = None
    kafka_producer = None
    try:
        logger.info("启动 Wikipedia 标题翻译服务...")
        kafka_consumer = setup_kafka_consumer()
        kafka_producer = setup_kafka_producer()
        process_messages(kafka_consumer, kafka_producer)
    except KafkaException as e:
        logger.critical(f"Kafka 设置失败,应用程序无法启动: {e}", exc_info=True)
    except Exception as e:
        logger.critical(f"应用程序因未处理的严重错误退出: {e}", exc_info=True)
    finally:
        # 确保在程序退出前关闭 Kafka 生产者并 flush 所有消息
        if kafka_producer:
            logger.info("正在关闭 Kafka 生产者并刷新剩余消息...")
            # flush() 阻塞直到所有排队消息被发送,添加超时参数
            try:
                kafka_producer.flush(timeout=15) # 设置一个合理的超时时间 (秒)
                logger.info("Kafka 生产者已成功刷新并关闭。")
            except Exception as e:
                logger.error(f"Kafka 生产者刷新或关闭时发生错误: {e}", exc_info=True)
        logger.info("翻译应用程序已关闭。")


if __name__ == "__main__":
    main()
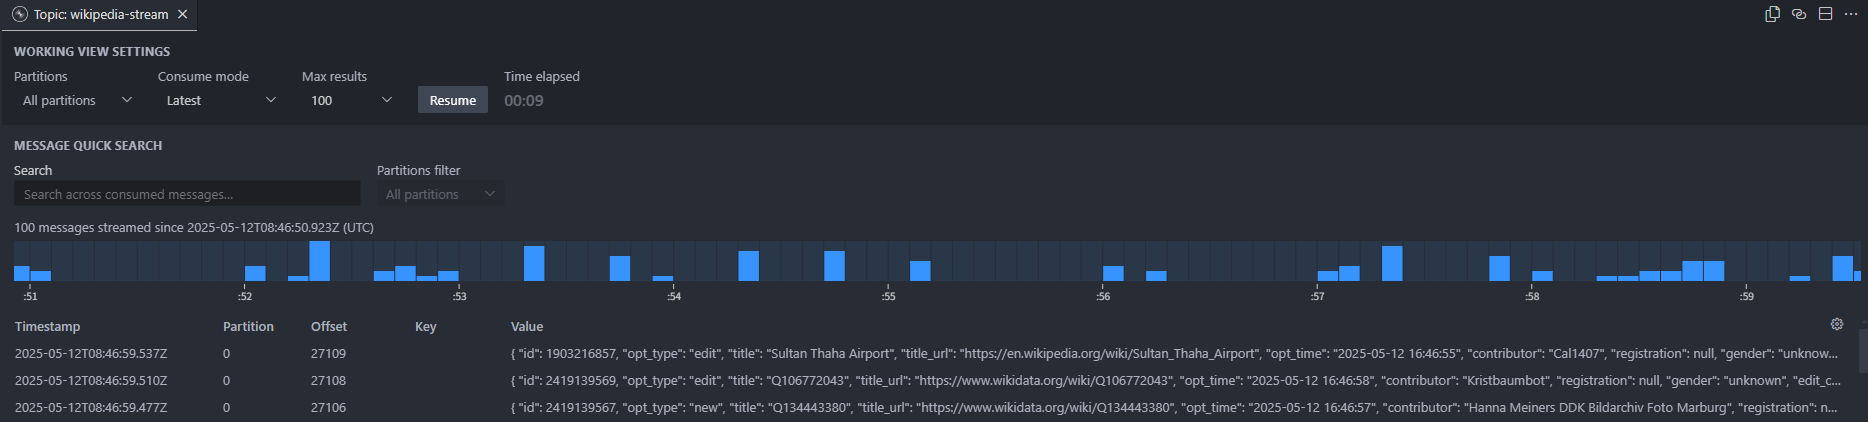
(4)查看 Kafka Topic 的数据
在 terminal 或是 在 VS Code 安装 Confluent 扩展查看 Topic 数据
5. 在 RisingWave 创建数据表和物化视图
https://docs.risingwave.com/ingestion/sources/kafka
psql -h 0.0.0.0 -p 4566 -d dev -U molihua
-- 操作数据层 / 贴源层
-- 创建数据表
CREATE TABLE IF NOT EXISTS ods_wiki_new_table (
    id bigint,
    opt_type VARCHAR,
    title VARCHAR,
    title_url VARCHAR,
    opt_time TIMESTAMP,
    contributor VARCHAR,
    registration TIMESTAMP,
    gender VARCHAR,
    edit_count VARCHAR,
    PRIMARY KEY (id)
) WITH (
    connector = 'kafka',
    topic = 'wikipedia-stream-new',
    properties.bootstrap.server = '192.168.31.72:9092',
    scan.startup.mode = 'earliest',
    properties.client.id = 'rw-consumer'
) FORMAT PLAIN ENCODE JSON;

select count(id) from ods_wiki_new_table;
select * from ods_wiki_new_table limit 10;


CREATE TABLE IF NOT EXISTS ods_wiki_new_translator_table (
    id bigint,
    opt_type VARCHAR,
    title VARCHAR,
    title_url VARCHAR,
    opt_time TIMESTAMP,
    contributor VARCHAR,
    title_zh VARCHAR,
    translated_at TIMESTAMP,
    PRIMARY KEY (id)
) WITH (
    connector = 'kafka',
    topic = 'wikipedia-new-translator',
    properties.bootstrap.server = '192.168.31.72:9092',
    scan.startup.mode = 'earliest',
    properties.client.id = 'rw-consumer'
) FORMAT PLAIN ENCODE JSON;

select count(id) from ods_wiki_new_translator_table;
select * from ods_wiki_new_translator_table limit 10;


-- 维表
-- https://wangchujiang.com/reference/docs/iso-639-1.html
-- https://zh.wikipedia.org/wiki/ISO_639-1代码列表
-- 数据手工导入,详见代码库 import_csv.ipynb
CREATE TABLE IF NOT EXISTS dim_language (
    language_code VARCHAR,
    language_name_zh VARCHAR,
    language_name_en VARCHAR,
    language_name_local VARCHAR,
    created_at TIMESTAMP DEFAULT current_timestamp()::timestamptz AT TIME ZONE 'Asia/Shanghai',
    updated_at TIMESTAMP DEFAULT current_timestamp()::timestamptz AT TIME ZONE 'Asia/Shanghai',
    PRIMARY KEY (language_code)
)
;

select current_timestamp() c1, current_timestamp() ::timestamptz AT TIME ZONE 'Asia/Shanghai' c2, current_timestamp()::timestamp c3;
select count(1) from dim_language;
select * from dim_language limit 10;


-- 明细层
CREATE MATERIALIZED VIEW dwd_wiki_new_detail AS
SELECT
    t1.id,
    t1.opt_type,
    t1.title,
    t1.title_url,
    t1.opt_time,
    t1.contributor,
    t1.registration,
    t1.gender,
    CAST(t1.edit_count AS INT) AS edit_count,
    COALESCE(t2.title_zh, 'NULL') AS title_zh,
    COALESCE(t2.translated_at, '1900-01-01') AS translated_at,
    t1.language_code,
    COALESCE(t3.language_name_zh, 'NULL') AS language_name_zh
FROM (
    SELECT *,
        split_part(
            split_part(
                title_url,
                '://',
                2
            ),
            '.',
            1
        ) AS language_code
    FROM ods_wiki_new_table
) t1
LEFT JOIN ods_wiki_new_translator_table t2 ON t1.id = t2.id
LEFT JOIN dim_language t3 ON t1.language_code = t3.language_code
WHERE t1.opt_type = 'new'
;

SELECT count(id) FROM dwd_wiki_new_detail;
SELECT * FROM dwd_wiki_new_detail LIMIT 10;


-- 汇总层
-- 注:在 Superset 使用的时候发现,应该将 opt_date 转换成日期类型或者增加一列日期时段字段,这样方便在 superset 中的筛选器使用
CREATE MATERIALIZED VIEW dws_wiki_new_sum AS
SELECT
    t1.opt_type,
    t1.contributor,
    to_char(t1.opt_time, 'YYYY-MM-DD') AS opt_date,
    to_char(t1.opt_time, 'HH24') AS opt_hour,
    t1.language_code,
    t1.language_name_zh,
    COUNT(DISTINCT id) AS article_cnt
FROM dwd_wiki_new_detail t1
GROUP BY
    t1.opt_type,
    t1.contributor,
    to_char(t1.opt_time, 'YYYY-MM-DD'),
    to_char(t1.opt_time, 'HH24'),
    t1.language_code,
    t1.language_name_zh
;

SELECT * FROM dws_wiki_new_sum LIMIT 10;
6. 使用 Superset 搭建数据看板
https://superset.apache.org/docs/configuration/databases/#risingwave
(1)安装依赖
pip install sqlalchemy-risingwave
(2)配置连接
risingwave://molihua:XXXXXXXXXX@127.0.0.1:4566/dev?sslmode=disable
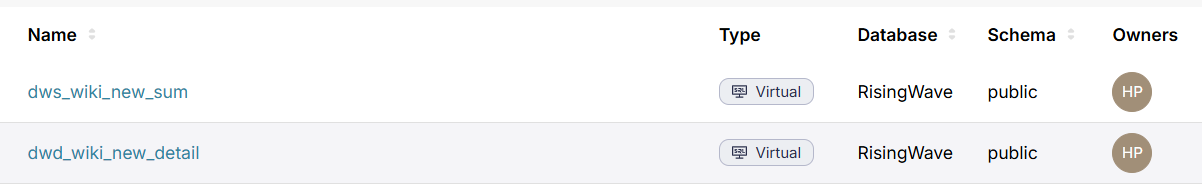
(3)创建数据集(Dataset)
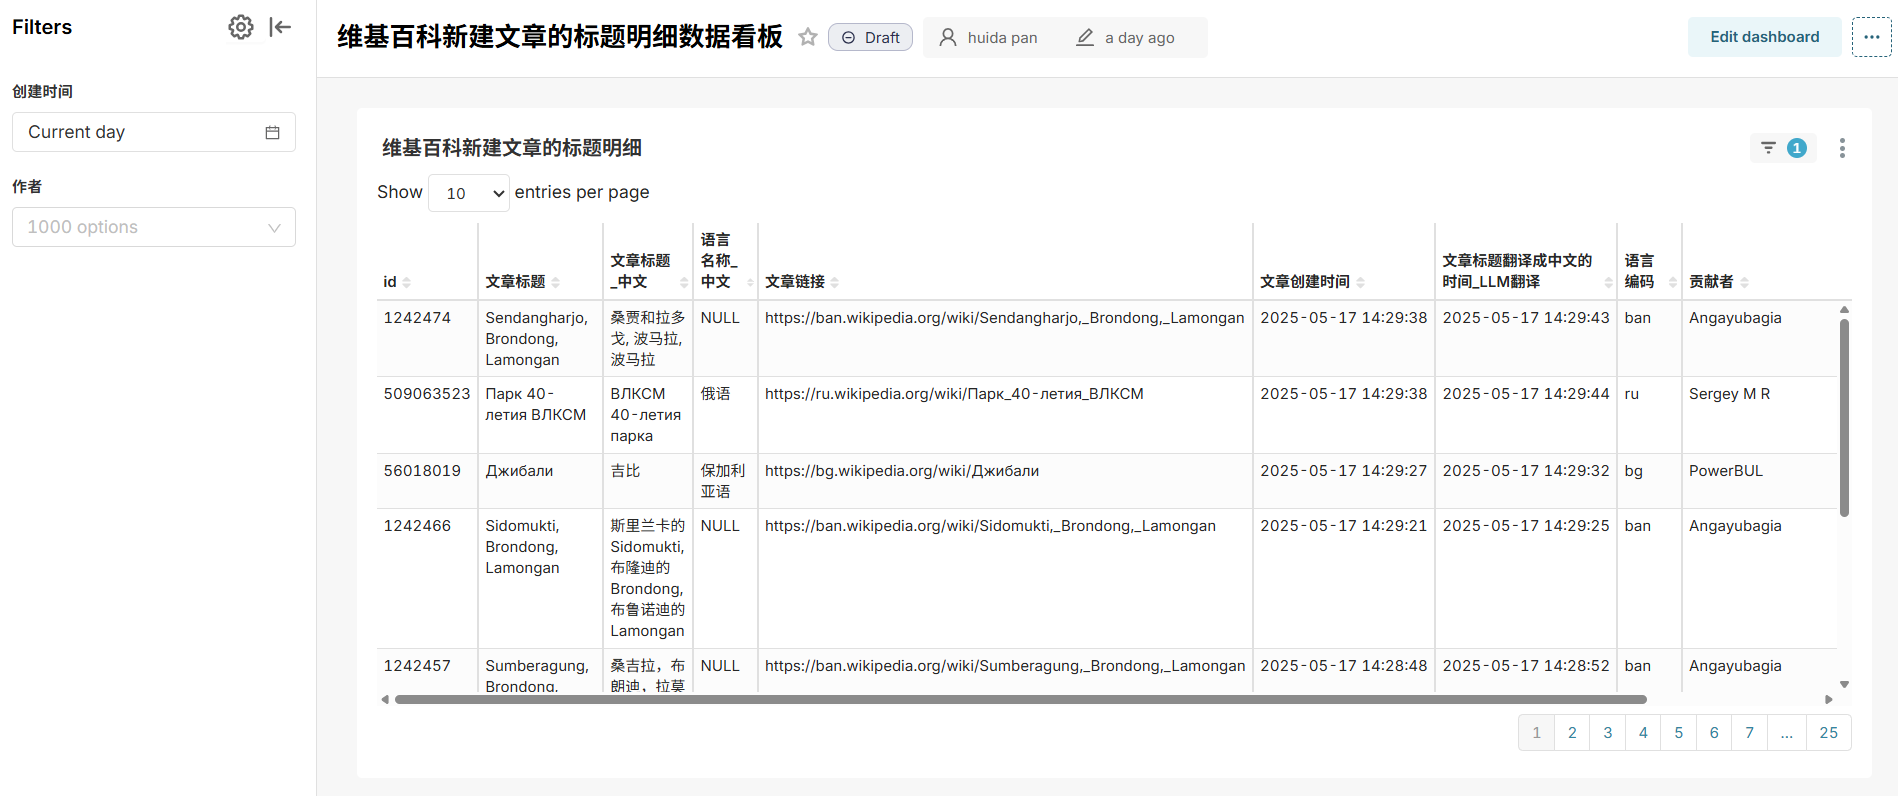
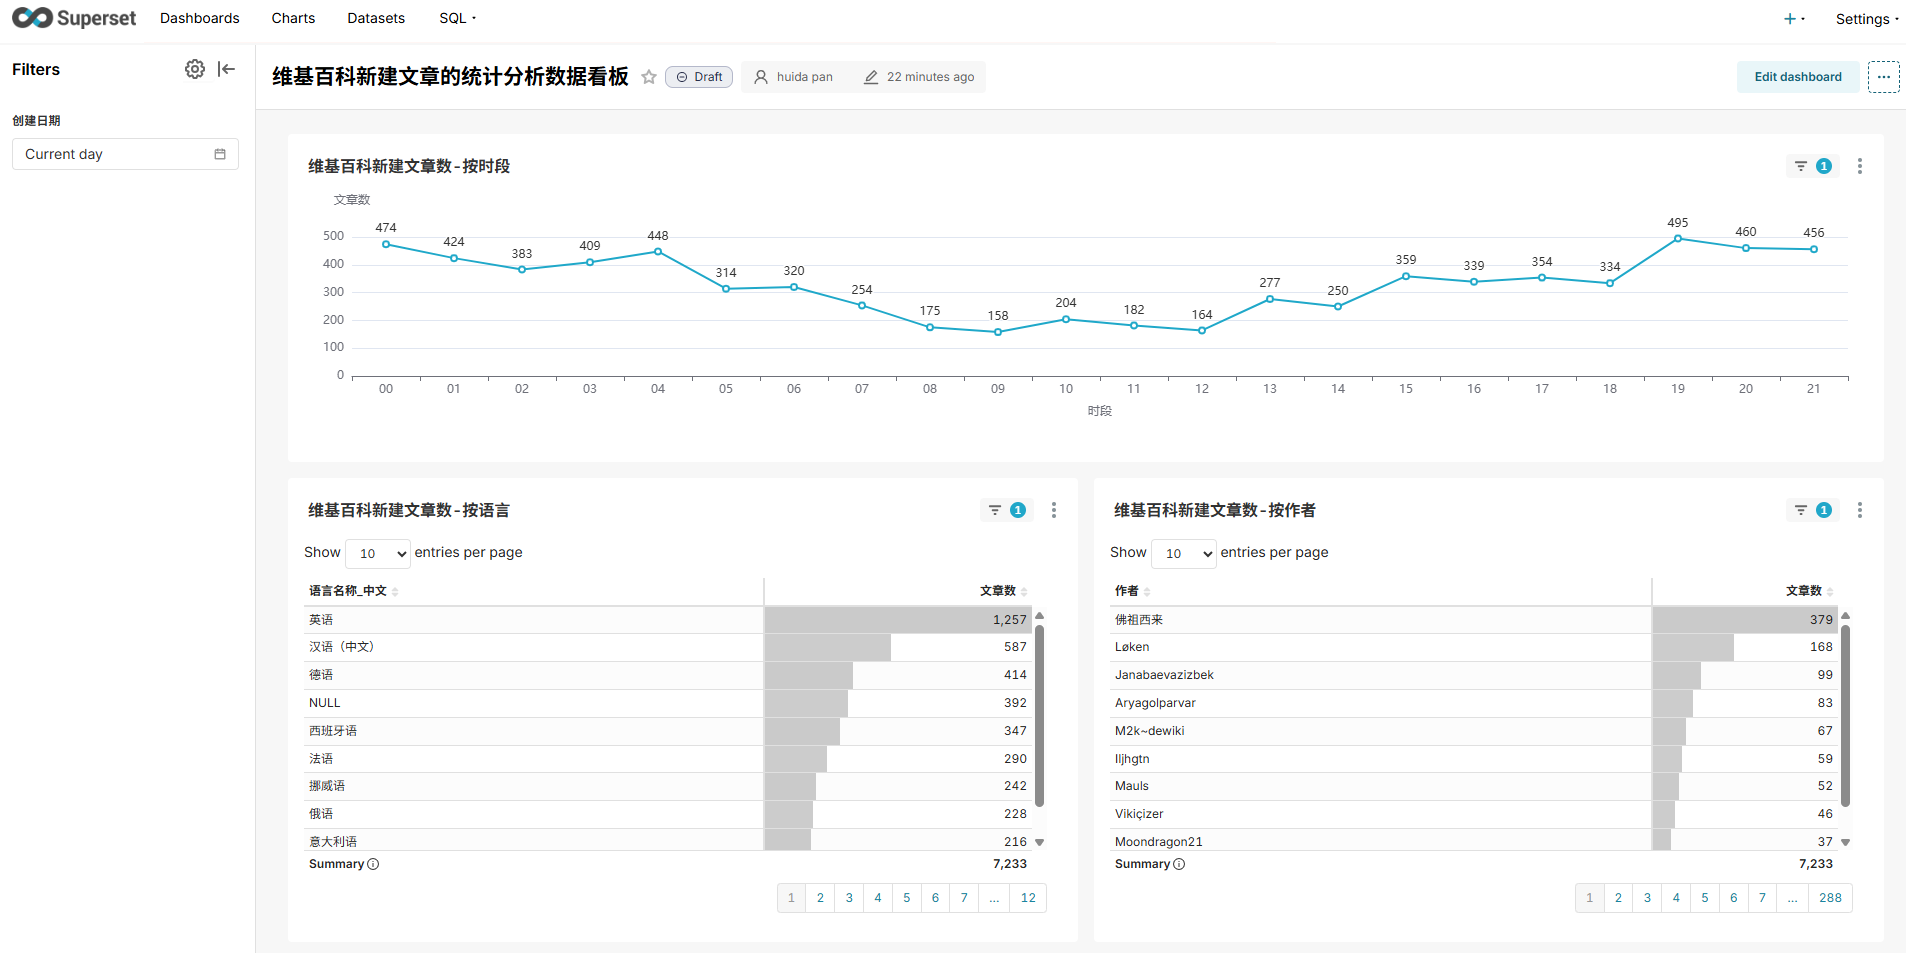
(4)制作 图表(Chart) 和 仪表板( Dashboard )
维基百科新建文章的统计分析数据看板
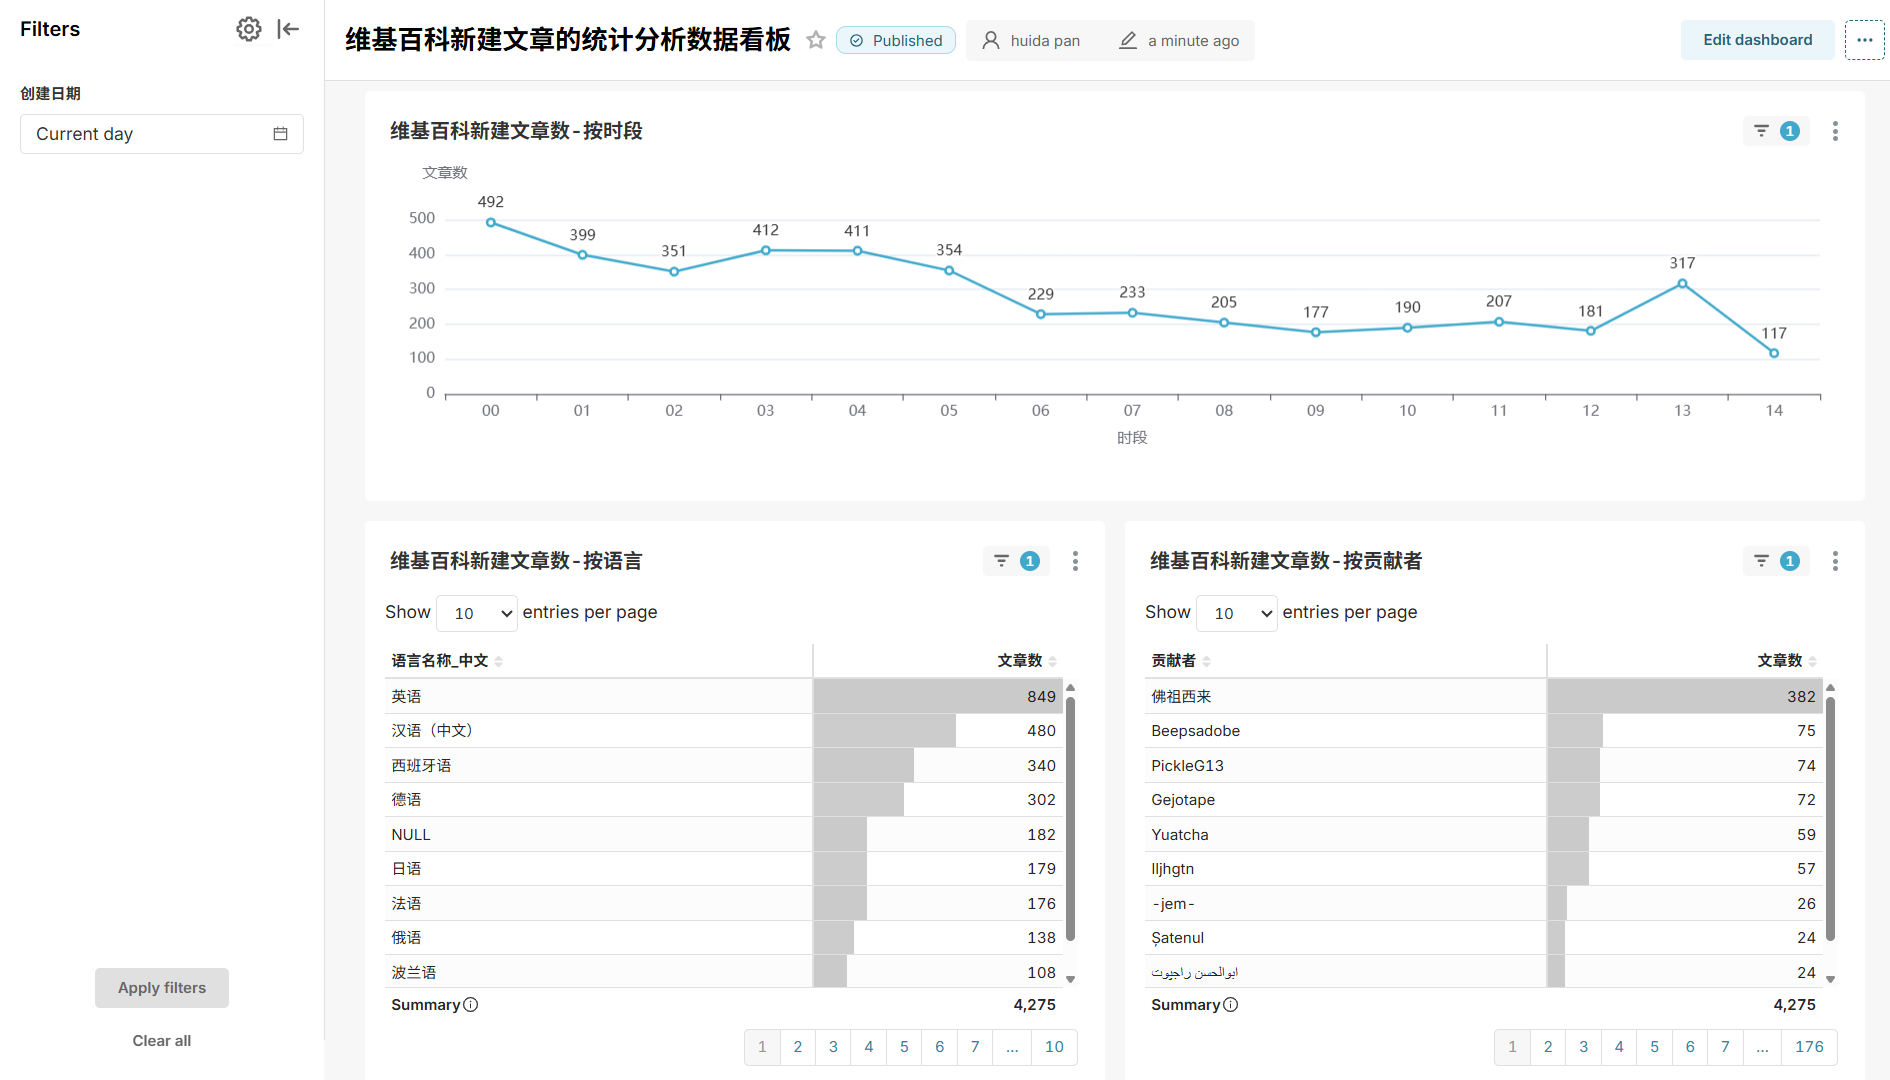
维基百科新建文章的标题明细数据看板
04 测试验证
1. 翻译校验
- 翻译对比
| 链接 | 原文 | google 翻译 | GPT-4o | qwen3:0.6b | 备注 |
|---|---|---|---|---|---|
| https://de.wikipedia.org/wiki/Maupasina | Maupasina | 莫帕西纳 | 毛帕西纳 | 马普斯纳 | |
| https://ru.wikipedia.org/wiki/Кобозев,_Александр_Александрович | Кобозев, Александр Александрович | 亚历山大·亚历山德罗维奇·科博泽夫 | 科博泽夫,亚历山大·亚历山大罗维奇 | 科博耶夫, 亚历山大·列夫尼科夫 | |
| https://vo.wikipedia.org/wiki/Jean-Claude_Chamboredon | Jean-Claude Chamboredon | 让-克洛德·尚博雷东 | 让-克洛德·尚博尔东 | 卡门·查布雷多诺 |
- ollama
curl -X POST http://192.168.31.72:11434/api/generate -H "Content-Type: application/json" -d '{
  "model": "qwen3:0.6b",
  "prompt": "将以下内容翻译成中文,仅输出翻译结果:Jean-Claude Chamboredon",
  "stream": false,
  "options": {"temperature": 0.1},
  "format": {
    "type": "object",
    "properties": {
      "source_text": {
        "type": "string"
      },
      "target_text": {
        "type": "string"
      }
    },
    "required": [
      "source_text",
      "target_text"
    ]
  }
}'
输出示例
{"model":"qwen3:0.6b","created_at":"2025-05-16T08:25:14.53937844Z","response":"{\n \"source_text\": \"Jean-Claude Chamboredon\",\n \"target_text\": \"卡门·查布雷多诺\"\n}\n","done":true,"done_reason":"stop","context":[151644,872,198,44063,87752,43815,105395,12857,104811,3837,99373,66017,105395,59151,5122,67909,7658,4260,793,910,2969,3018,263,151645,198,151644,77091,198,515,220,330,2427,4326,788,330,67909,7658,4260,793,910,2969,3018,263,756,220,330,5657,4326,788,330,99603,64689,13935,32876,51827,96465,42140,101176,698,532],"total_duration":1313759608,"load_duration":27650315,"prompt_eval_count":28,"prompt_eval_duration":9698263,"eval_count":33,"eval_duration":1275165486}
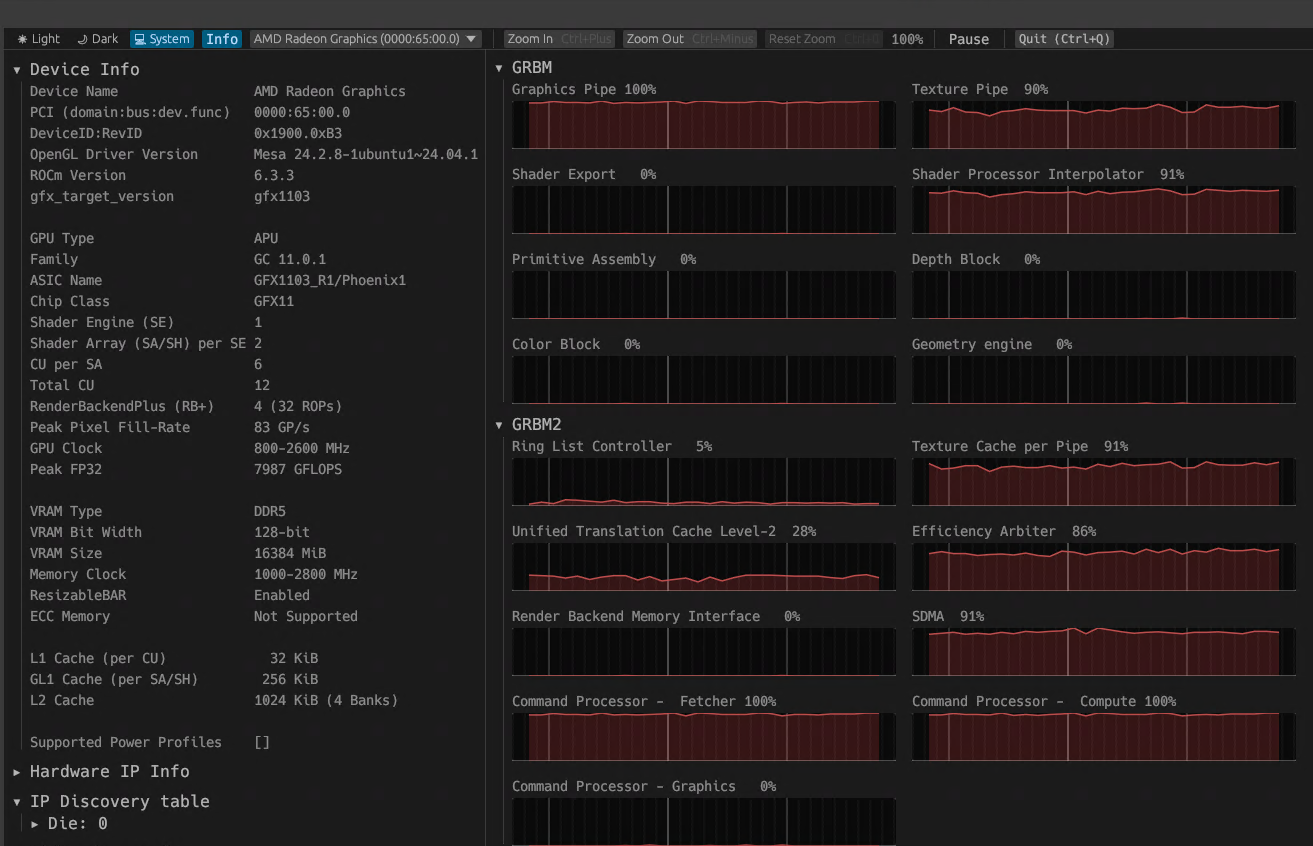
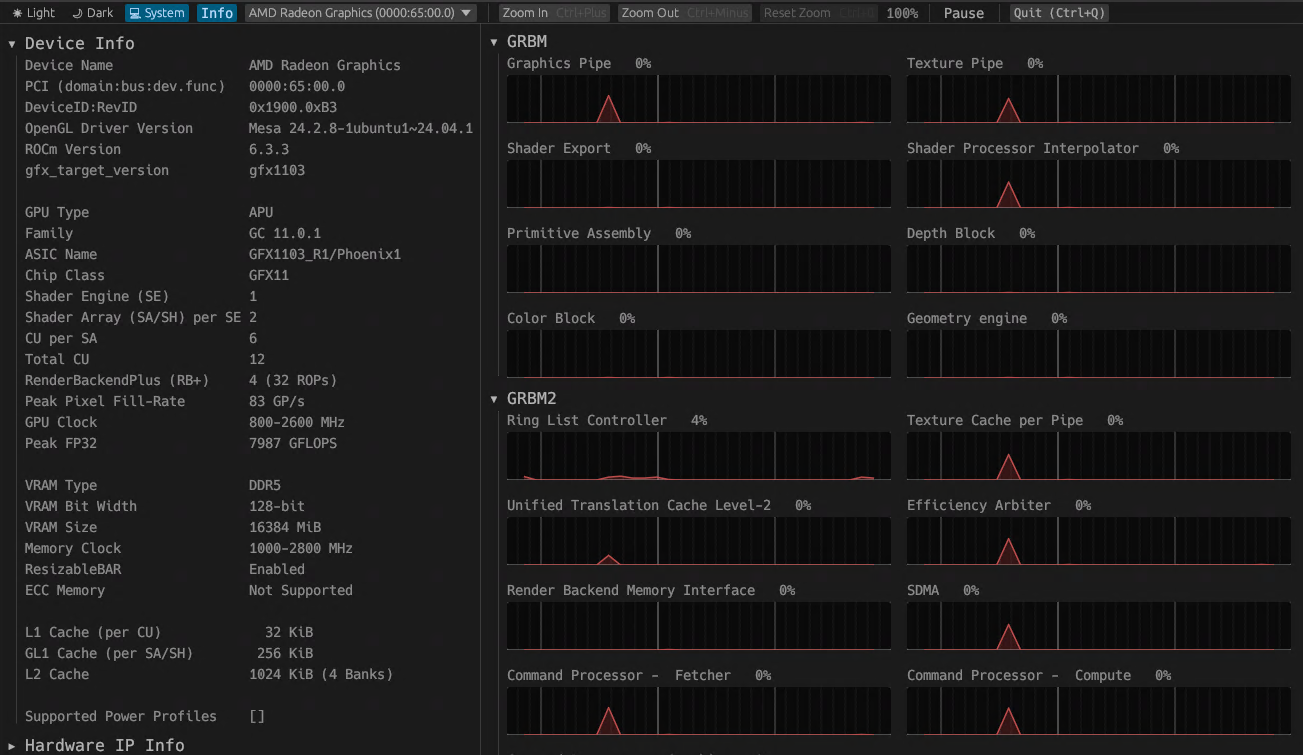
2. 集成 GPU 负载
数据初始化的负载很高
运行数据管道的时候很少
3. 文章 URL 解码后的示例
{
  "partition_id": 0,
  "offset": 3112,
  "timestamp": 1747230297063,
  "headers": [],
  "key": null,
  "value": {
    "id": 7508430,
    "opt_type": "new",
    "title": "అర్స్లాన్ ఖాన్",
    "title_url": "https://te.wikipedia.org/wiki/అర్స్లాన్_ఖాన్",
    "opt_time": "2025-05-14 21:44:53",
    "contributor": "Pranayraj1985",
    "registration": null,
    "gender": "unknown",
    "edit_count": "0"
  },
  "metadata": {
    "value_metadata": {
      "data_format": "JSON"
    }
  }
}
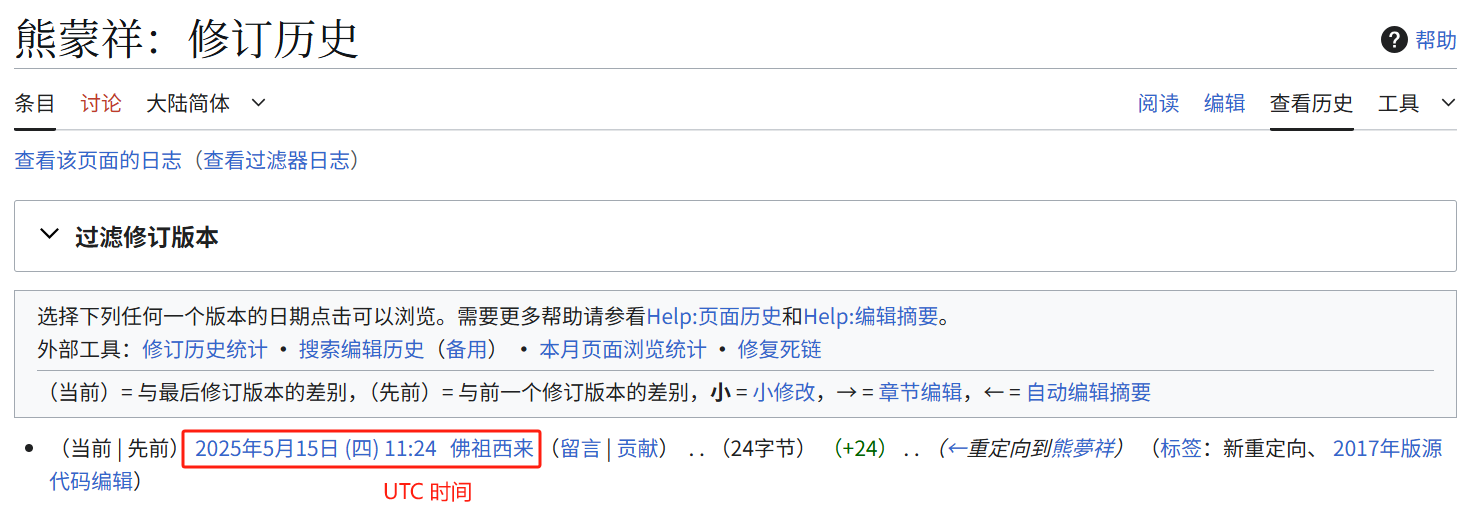
4. 数据验证
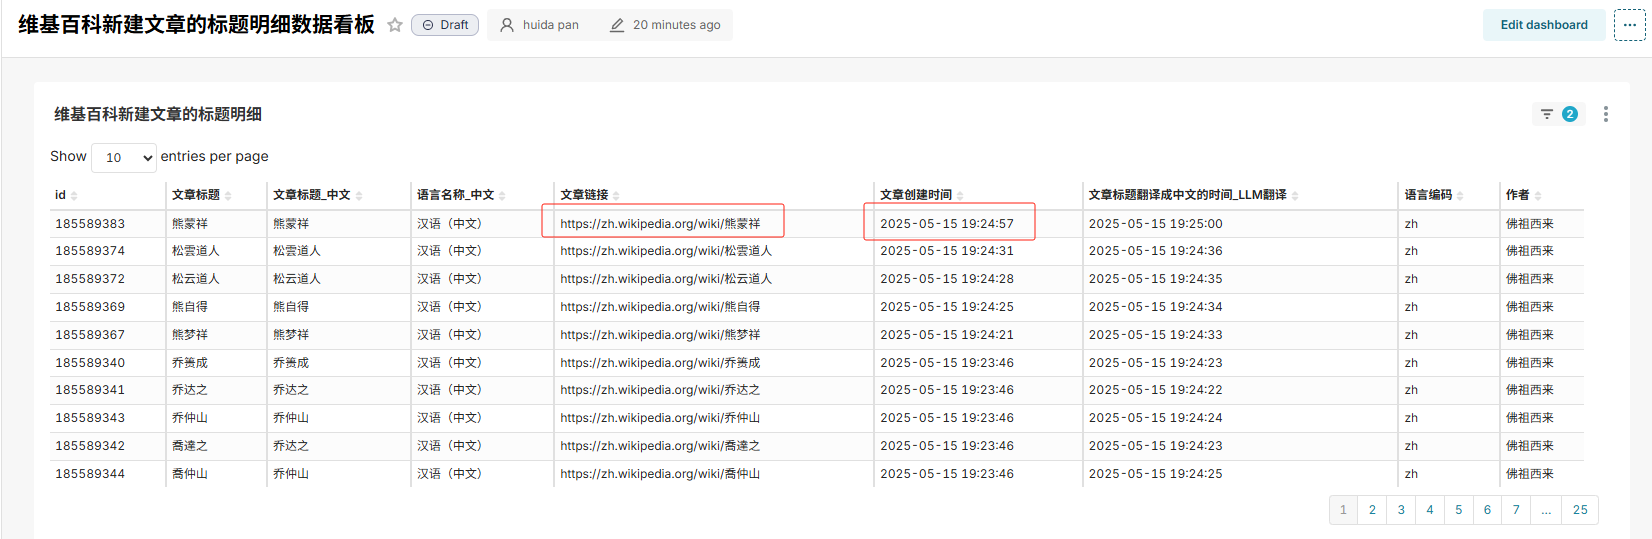
https://zh.wikipedia.org/w/index.php?title=熊蒙祥&action=history
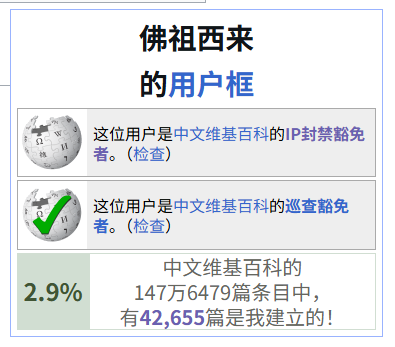
https://zh.wikipedia.org/wiki/User:佛祖西来
05 问题
1. RisingWave 字段类型不匹配
在 RisingWave 创建了 Kafka 数据源,在 RisingWave 查询数据发现 opt_time 字段的值为空
Kafka
{
  "partition_id": 0,
  "offset": 3972,
  "timestamp": 1747014810685,
  "headers": [],
  "key": null,
  "value": {
    "id": 2851423802,
    "opt_type": "edit",
    "title": "File:千里インターチェンジ.jpg",
    "title_url": "https://commons.wikimedia.org/wiki/File:%E5%8D%83%E9%87%8C%E3%82%A4%E3%83%B3%E3%82%BF%E3%83%BC%E3%83%81%E3%82%A7%E3%83%B3%E3%82%B8.jpg",
    "opt_time": "2025-05-12 09:53:29",
    "contributor": "SchlurcherBot",
    "registration": null,
    "gender": "unknown",
    "edit_count": "0"
  },
  "metadata": {
    "value_metadata": {
      "data_format": "JSON"
    }
  }
}

RisingWave
CREATE SOURCE wiki_source (
    id bigint,
    opt_type VARCHAR,
    title VARCHAR,
    title_url VARCHAR,
    opt_time TIMESTAMPTZ,
    contributor VARCHAR,
    registration TIMESTAMPTZ,
    gender VARCHAR,
    edit_count VARCHAR
) WITH (
  connector = 'kafka',
  topic='wikipedia-stream',
  properties.bootstrap.server = '192.168.31.72:9092',
  scan.startup.mode = 'latest',
  properties.client.id='rw-consumer'
) FORMAT PLAIN ENCODE JSON;


CREATE MATERIALIZED VIEW wiki_mv AS
SELECT
    id,
    opt_type,
    title,
    title_url,
    CAST(opt_time AS TIMESTAMP) AS opt_time,
    contributor,
    CAST(registration AS TIMESTAMP) AS registration,
    gender,
    CAST(edit_count AS INT) AS edit_count
FROM wiki_source
WHERE opt_type IS NOT NULL
;

dev=> select id, opt_time from wiki_mv where id = 2851423802;
     id     | opt_time
------------+----------
 2851423802 |
解决方案
https://gemini.google.com/app/f9194ad5f6ae59e7
opt_time 字段在 RisingWave 中显示为空的最可能原因是 RisingWave 在尝试将 Kafka 中的字符串 "2025-05-12 09:53:29" 直接解析为 TIMESTAMPTZ 类型时失败了
TIMESTAMPTZ (Timestamp with time zone) 类型期望包含时区信息的字符串(例如 "2025-05-12 09:53:29+08" 或 "2025-05-12T09:53:29Z")。然而,你的 Kafka 数据中的 opt_time 字符串 "2025-05-12 09:53:29" 并没有包含任何时区信息。
最直接的解决方法是更改 CREATE SOURCE 语句中 opt_time 字段的数据类型,将其从 TIMESTAMPTZ 改为 TIMESTAMP。
06 参考资料
1.基于 RisingWave、Instaclustr 和 Apache Superset 对维基百科实时监控
https://mp.weixin.qq.com/s/5Pj0kSVKQnxjlSuA-1WoSw
2. Wikitech
https://wikitech.wikimedia.org/wiki/Main_Page
Data Platform
https://wikitech.wikimedia.org/wiki/Data_Platform
Analytics Data Platform 2021
https://upload.wikimedia.org/wikipedia/labs/5/5f/WMF_Analytics_Data_Platform_2021_v1.png
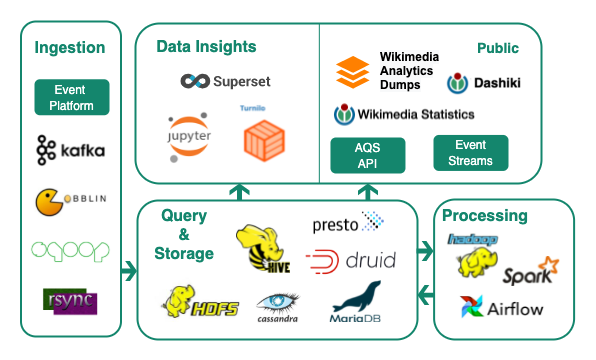
注: Ingestion 中的 Event Platform 详见 https://wikitech.wikimedia.org/wiki/Event_Platform
Data Platform Technical Overview 2023
https://wikitech.wikimedia.org/wiki/File:WMF_Data_Platform_Technical_Overview_2023_V1.jpg
07 附录
1. google 翻译
https://codelabs.developers.google.com/codelabs/cloud-translation-python3?hl=zh-cn