AI 编程 - 开发微信公众号阅读助手工具
记录使用 AI coding agent 开发微信公众号阅读助手工具的过程
将 本地文档搜索助手 中的采集公众号文章的模块,使用规范驱动开发的 AI 编程方式重新实现了一遍,打造了一个小而美的公众号文章阅读工具 — 微信公众号阅读助手。
这次还是规范驱动开发的 AI 编程 的一次尝试、练习,记录了更多的过程信息,希望这个工具、过程记录、项目代码对大家有一些帮助。
01 介绍
微信公众号阅读助手,一个可以自动获取公众号所有文章并可以下载所有文章的工具。
1. 界面
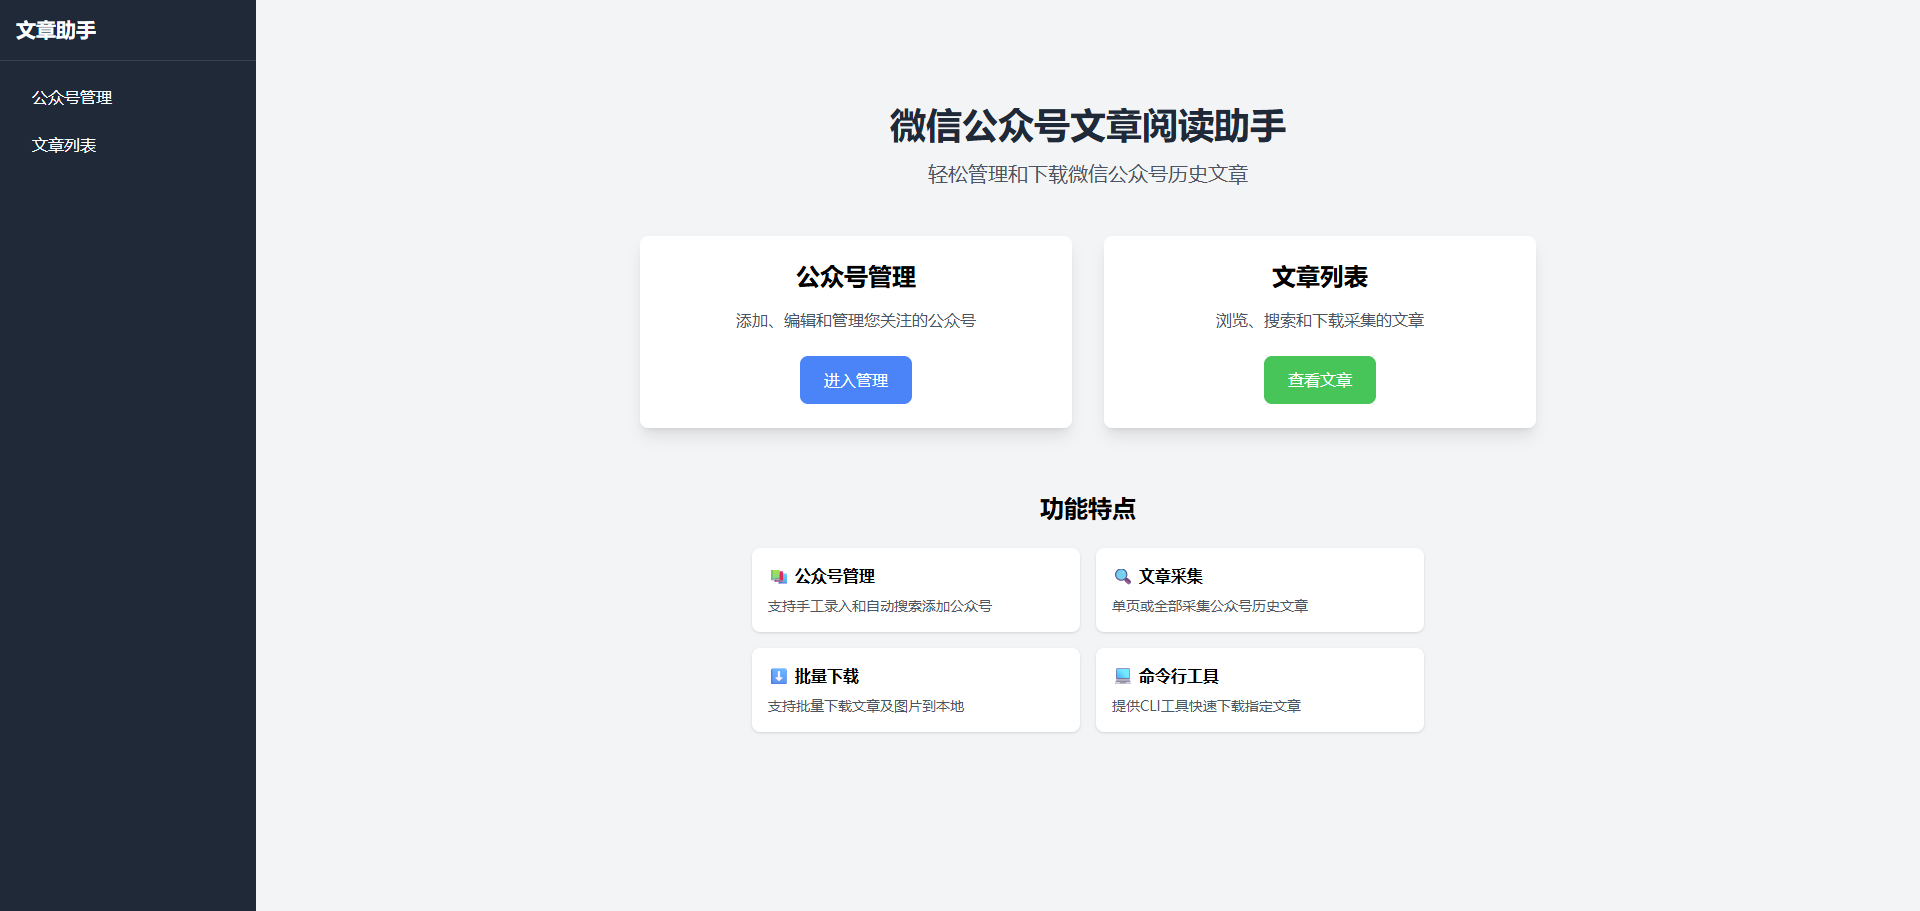
(1)首页
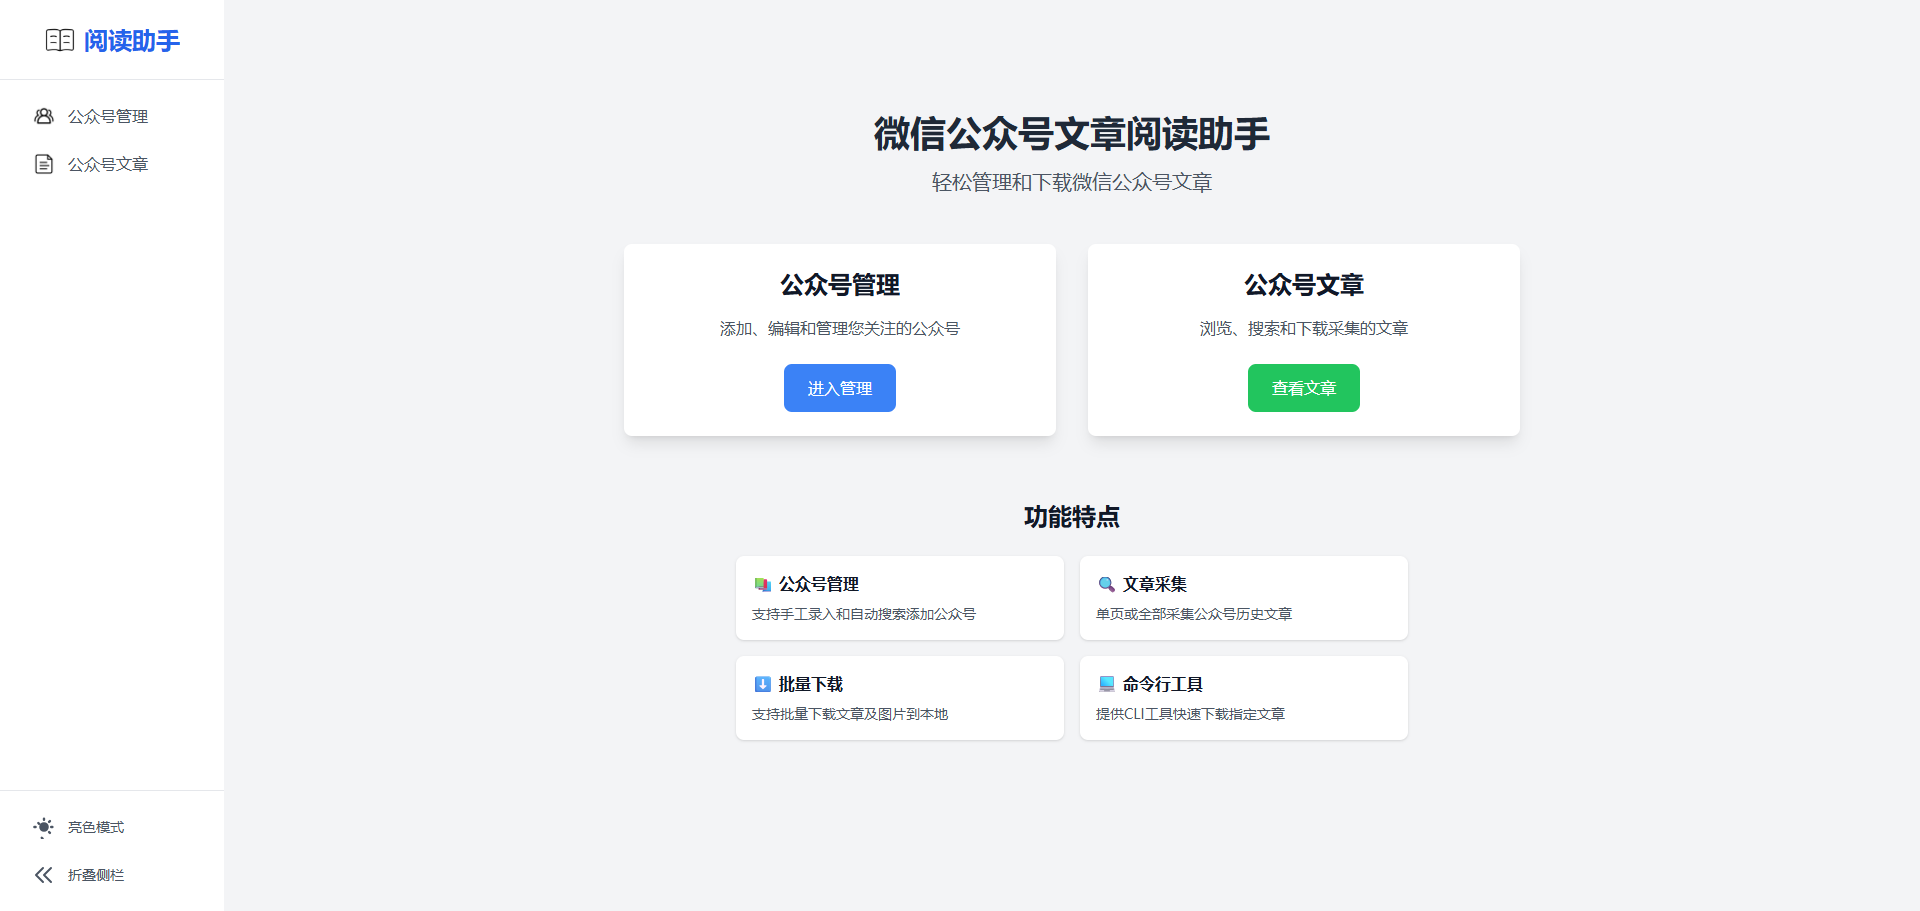
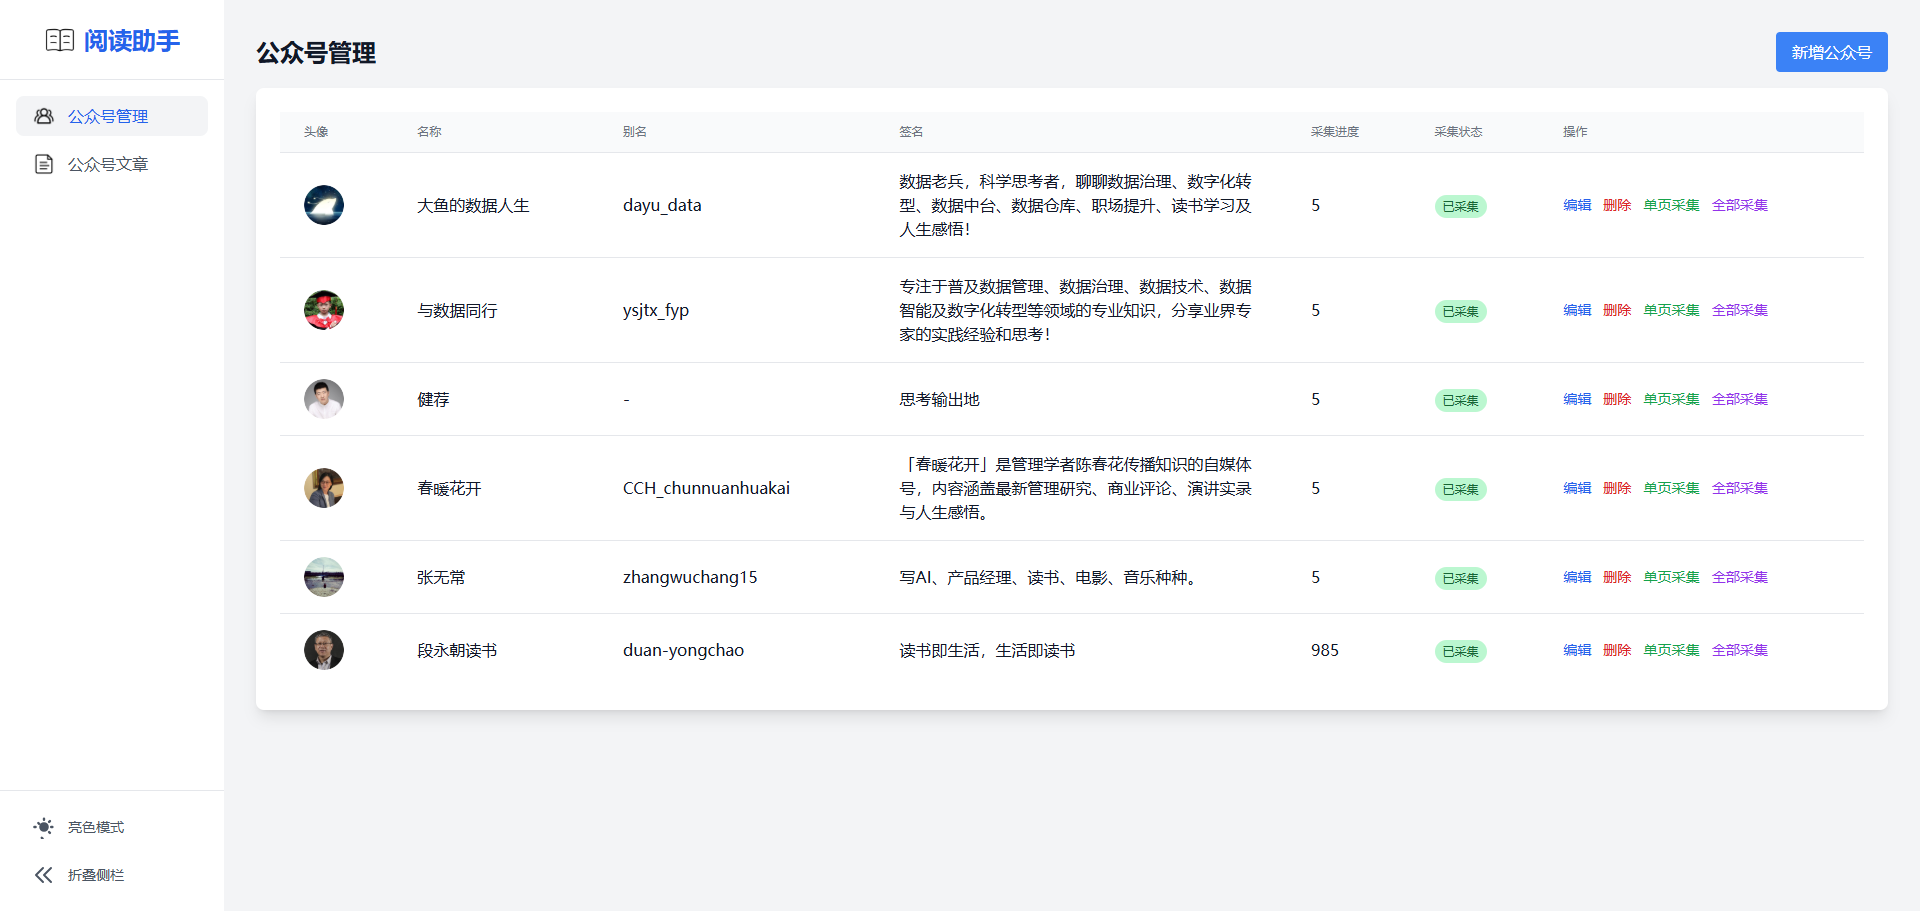
(2)公众号管理
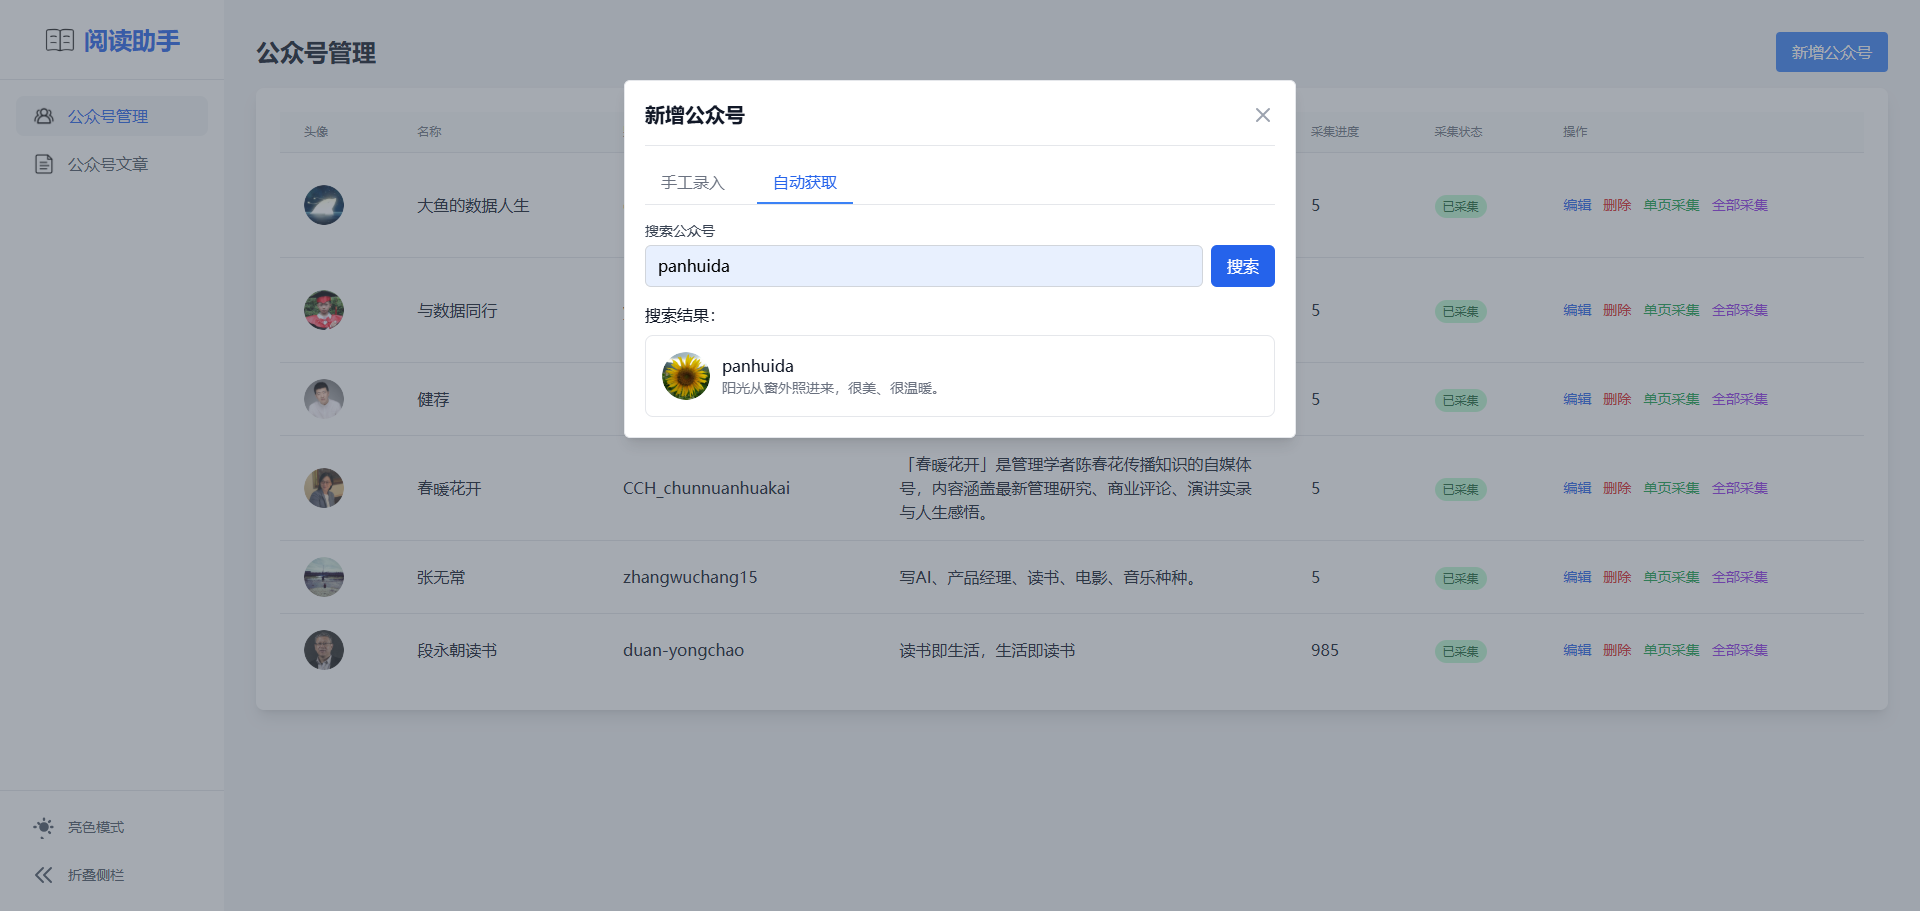
(3)搜索公众号
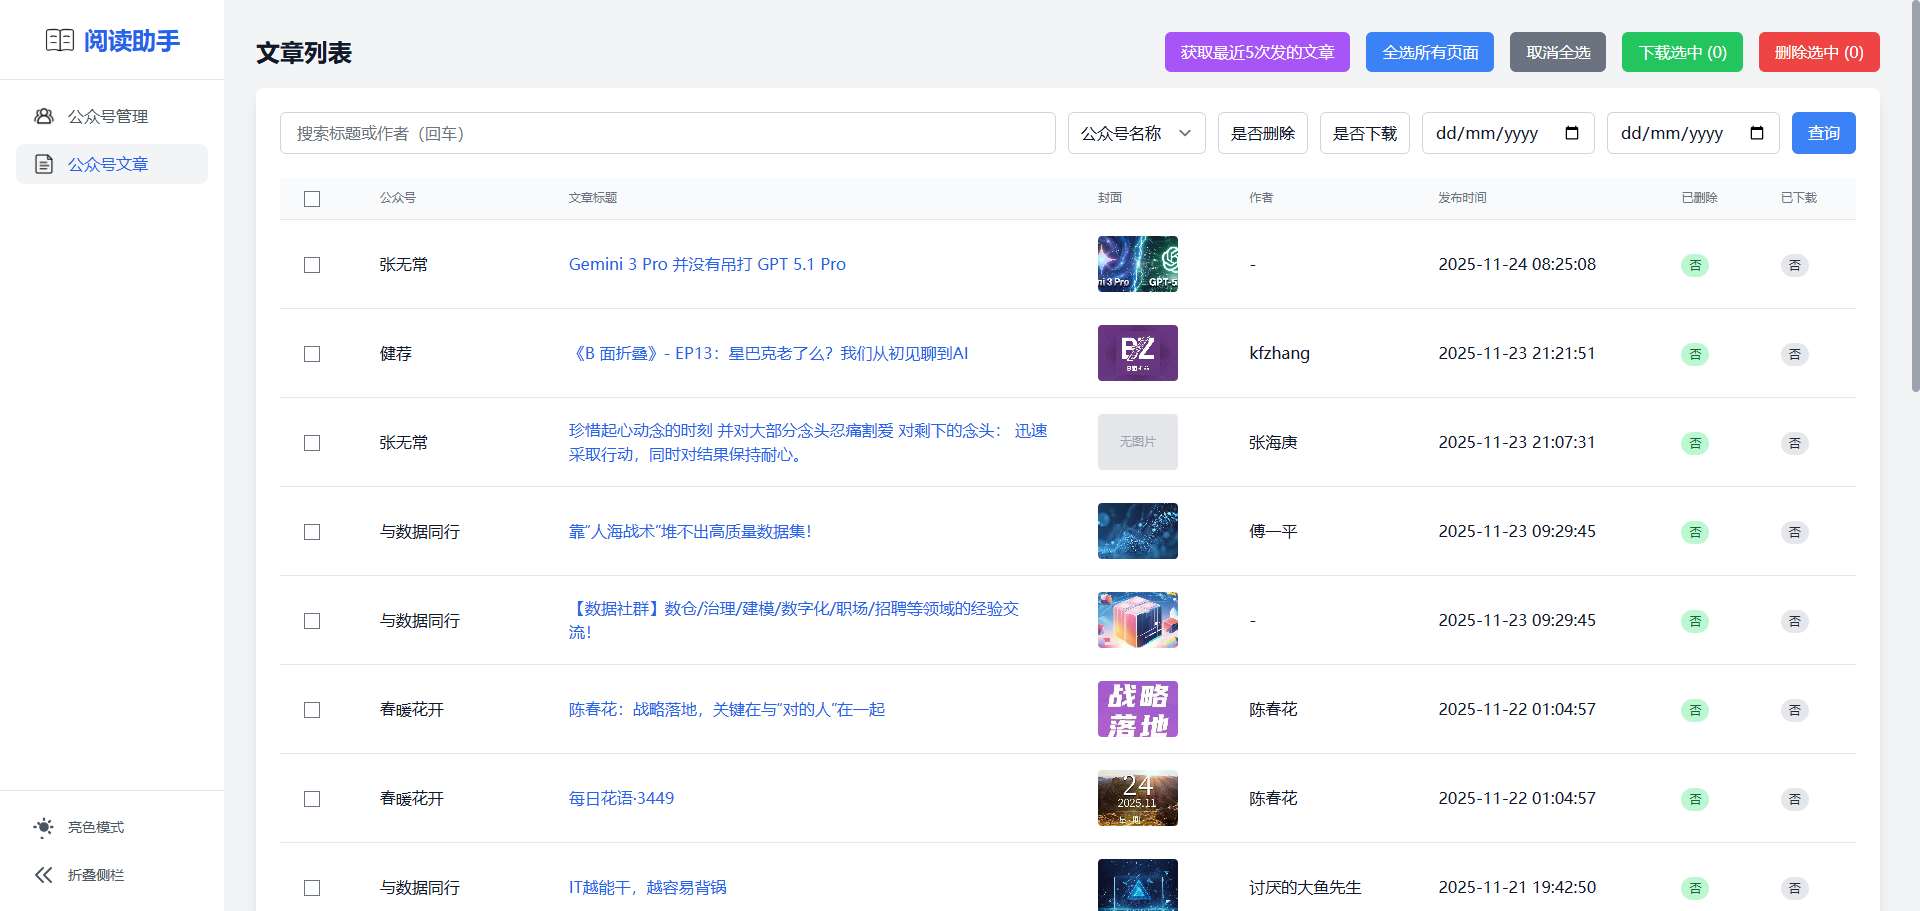
(4)公众号文章
2. PRD
【腾讯文档】微信公众号文章阅读助手PRD https://docs.qq.com/markdown/DVUFGWHJ1bExQYXpu
3. 代码库
微信公众号文章阅读助手
https://github.com/panhuida/wechat-article-assistant
02 如何实现
1. 蓝图
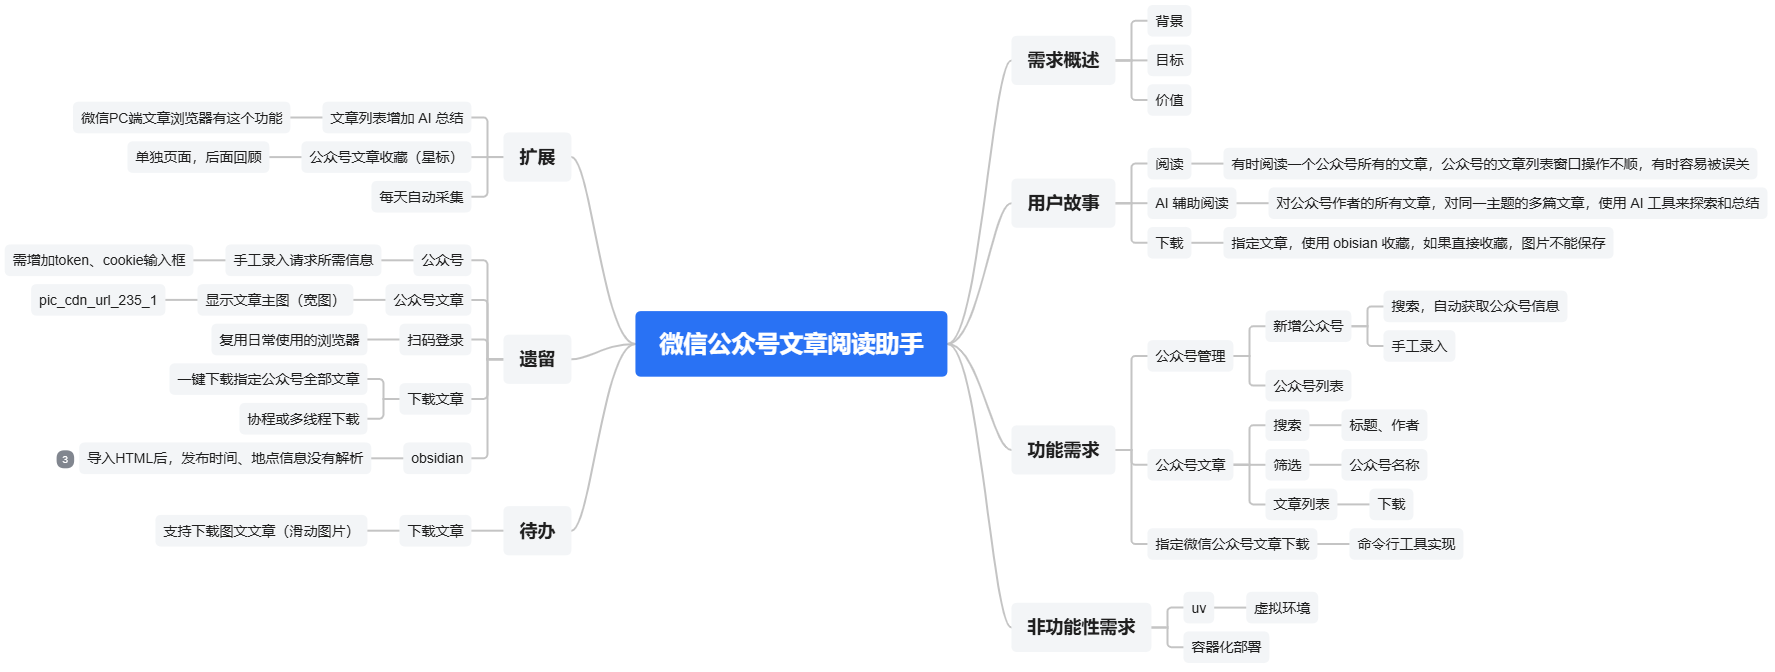
2. AI 编程
先确定 PRD(产品需求文档),再使用 AI 编程实现。
可以先梳理一个功能清单、项目结构、技术栈等主要内容(这些也可以使用 AI 来确定),使用多个 AI 工具辅助,确定最终的 PRD 。
具体的 PRD 结构、内容详细程度,大家可以多尝试。对我来说,我是要从 AI 编程实现的代码中学习一些编程技能,所以我会明确使用的技术栈。
目前我试下来,Claude(Sonnet 4.5)生成的 PRD 最详细。
确定 PRD 之后,使用 AI 编程助手来实现。
这次主要使用的是 GitHub Copilot(模型选择的是 Claude Sonnet 4.5)。
( 第一次听说 GitHub Copilot,是从 清来 那里听到的 )
如下是从 PRD 到 AI 编程的关键过程记录。
(1)我自己用的 PRD 结构
- 执行概要(Executive Summary)
- 功能需求(Features)
- 技术架构(Technologies Used)
- 数据模型(Database Schema)
- API 端点(API Endpoints)
- 项目结构(Project Structure)
- 页面设计(UI)
- 非功能性需求
(2)微信公众号文章阅读助手 PRD 的提示词
帮我编写一份产品需求文档(PRD)。请基于如下构建的内容和PRD的目录结构编写,并提供可以复制或下载的Markdown版本。


**1. 构建的内容**

这是一个用于采集微信公众号历史文章列表并支持下载文章的Web应用项目。


需要包含的功能需求如下:

- 提供一个公众号管理页面,用于录入和编辑公众号的信息
  - 点击新增公众号按钮,弹出公众号信息录入界面
    - 手工录入公众号信息
    - 自动获取公众号信息(通过微信公众平台账号搜索接口https://mp.weixin.qq.com/cgi-bin/searchbiz获取)
      - 输入公众号名称后点搜索时,遇到公众号登录态失效时,弹出微信公众平台(https://mp.weixin.qq.com/)的二维码,扫码登录后,保存登录态下次使用

  - 点击公众号列表对应的采集按钮,可以获取指定公众号的历史文章信息(支持采集单页、采集全部)
    - 采集公众号列表时,遇到公众号登录态失效时,弹出微信公众平台(https://mp.weixin.qq.com/)的二维码,扫码登录后,保存登录态下次使用

- 提供一个公众号文章页面,用于展示公众号历史文章列表
  - 支持筛选
  - 选择文章,可以下载选择的文章(支持单选、全选)
    - 在下载选中文章时,先检查是否有以“公众号名称”命名的文件夹,没有的话先创建文件夹,然后将下载的文章保存在这个文件夹下

- 提供命令行下载指定公众号文章链接(支持以文件方式提供公众号文章链接)


项目结构如下:

```shell
wechat-article-assistant/
├── src/
│   └── wechat_article_assistant/
├── tests/
├── docs/
├── requirements.txt
├── pyproject.toml
├── .env.example
├── README.md
├── .gitignore
└── LICENSE
```


需要使用的技术栈如下:

- 后端框架:Flask (Python 3.12+)
- 前端样式:Tailwind CSS (CDN加载)
- 数据库:SQLite
- ORM:SQLAlchemy
- 配置管理:python-dotenv
- 依赖管理:uv
- 代码格式:Ruff
- 类型检查:mypy
- 测试框架:pytest


数据模型如下:

- 公众号列表(wechat_list)

| 字段中文名称      | 字段英文名称   | 字段类型     | 字段是否为空说明 |
| ----------------- | -------------- | ------------ | ---------------- |
| 序号              | id             | int          | NOT NULL         |
| 公众号唯一标识    | fakeid         | varchar(100) | NULL             |
| 公众号名称        | nickname       | varchar(50)  | NULL             |
| 公众号别名        | alias          | varchar(50)  | NULL             |
| 公众号圆形头像URL | round_head_img | varchar(200) | NULL             |
| 公众号类型        | service_type   | varchar(10)  | NULL             |
| 公众号签名        | signature      | varchar(200) | NULL             |
| 公众号认证状态    | verify_status  | varchar(10)  | NULL             |
| 备注              | memo           | varchar(200) | NULL             |
| 单页起始位置      | begin          | int          | NULL             |
| 单页采集数量      | count          | int          | NULL             |
| 采集状态          | collect_status | varchar(50)  | NULL             |
| 创建时间          | create_time    | timestamp    | NULL             |
| 更新时间          | update_time    | timestamp    | NULL             |

- 公众号文章列表(wechat_article_list)

| 字段中文名称 | 字段英文名称        | 字段类型     | 字段是否可以为空 |
| ------------ | ------------------- | ------------ | ---------------- |
| 序号         | id                  | int          | NOT NULL         |
| 公众号列表ID | wechat_list_id      | int          | NULL             |
| 公众号名称   | nickname            | varchar(50)  | NULL             |
| 文章ID       | article_id          | varchar(50)  | NULL             |
| 文章标题     | article_title       | varchar(50)  | NULL             |
| 文章封面     | article_cover       | varchar(200) | NULL             |
| 文章链接     | article_link        | varchar(200) | NULL             |
| 文章作者     | article_author_name | varchar(20)  | NULL             |
| 文章是否删除 | article_is_deleted  | varchar(10)  | NULL             |
| 文章创建时间 | article_create_time | timestamp    | NULL             |
| 文章更新时间 | article_update_time | timestamp    | NULL             |
| 是否下载     | is_downloaded       | varchar(10)  | NULL             |
| 创建时间     | create_time         | timestamp    | NULL             |
| 更新时间     | update_time         | timestamp    | NULL             |


**2. PRD 目录结构**

- 执行概要(Executive Summary)
- 功能需求(Features)
- 技术架构(Technologies Used)
- 数据模型(Database Schema)
- API 端点(API Endpoints)
- 项目结构(Project Structure)
- 页面设计(UI)
- 非功能性需求


我会使用 AI copilot 来构建这个应用。

如果你有任何需要澄清的问题,可以问我。

如果你有任何需要我补充的信息,可以向我提出。
(3)使用 GitHub Copilot 编程实现示例
在 VS Code 中使用 GitHub Copilot,模型选择的是 Claude Sonnet 4.5,模式选择的是 GitHub Copilot CLI Agent(我选择 GitHub Copilot CLI Agent,一是为了后面在 GitHub Copilot CLI 里继续迭代优化,二是测试一下 GitHub Copilot 这个新的功能) 。
注:在 使用 AI 编程实现时,要创建一个 git 项目仓库。
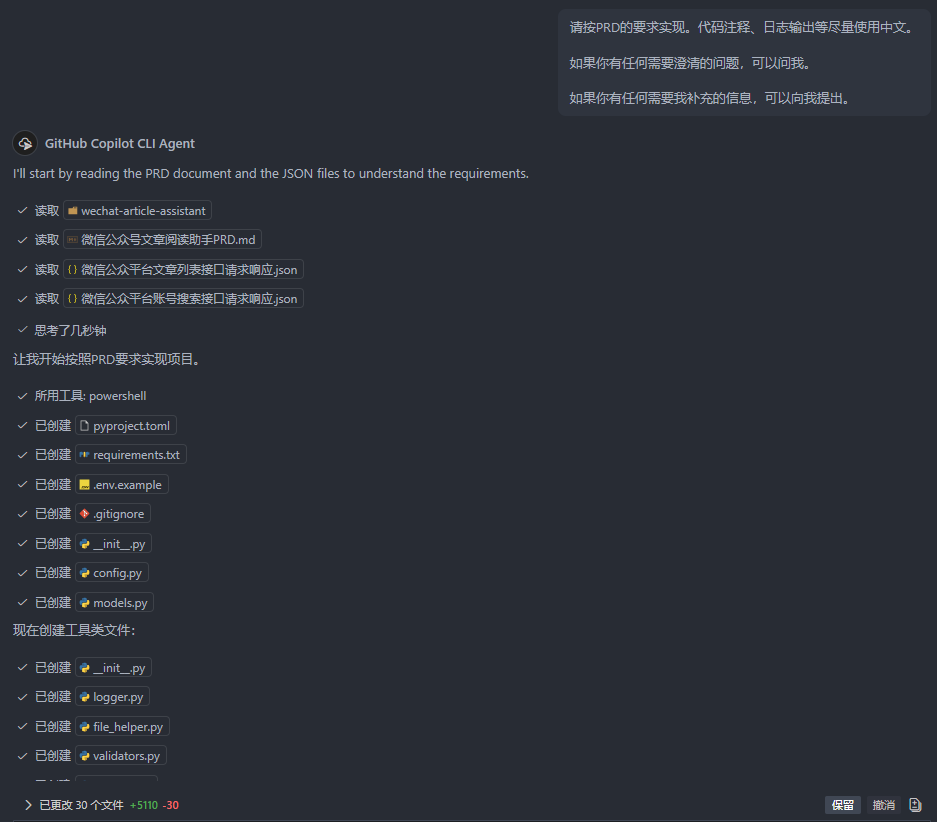
如下是 AI 编程完成之后运行的界面( AI 写完代码能够运行,而且界面符合要求,这个超预期了)。
(4)解决问题示例 - 登录态处理
注:涉及微信公众平台扫码登录,比较复杂,需要提供处理流程等信息。
注:在 使用 AI 解决问题时,解决一个问题,建议提交一下代码,避免后面 AI 改乱代码。
发现没有记录成功解决问题的对话记录,如下是一些关键信息示例。
- 提示示例
在公众号管理中,自动获取,出现如下问题,运行日志如下,请解决。对话、修改代码等尽量使用中文。

问题:

- 在启动的浏览器上扫码成功后,启动的浏览器没有关闭,“微信公众平台登录”弹框没有变化
- “微信公众平台登录”弹框的“登录二维码“没有加载成功

日志:

如果你有任何需要澄清的问题,可以问我。

如果你有任何需要我补充的信息,可以向我提出。
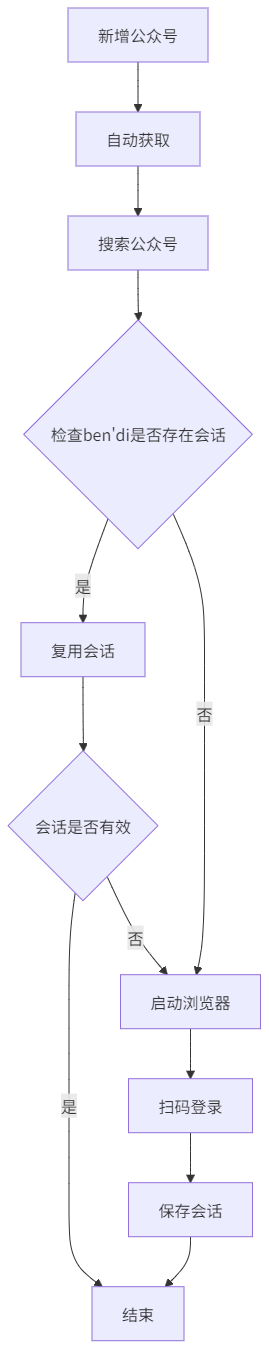
- 登录态处理流程
使用 Mermaid 来画流程图,向 AI 编程助手提供上下文信息。
flowchart TD
    A[新增公众号] --> B[自动获取]
    B --> C[搜索公众号]
    C --> D{检查ben'di是否存在会话}
    D -->|是| E[复用会话]
    D -->|否| F[启动浏览器]
    E --> G{会话是否有效}
    G -->|是| H[结束]
    G -->|否| F
    F --> I[扫码登录]
    I --> J[保存会话]
    J --> H
(5)新增功能示例 - 获取最新文章
- 提示示例
请在"文章列表"页面增加"获取最近5次发的文章"的功能,具体需求如下:

- 在"文章列表"页面增加"获取最近5次发的文章"的按钮,按钮放在"下载选中"按钮的左边

- 点击"获取最近5次发的文章",每次获取所有公众号最近5次发的文章(起始位置为0,采集数量为5)

- 参考"公众号管理"页面中的"单页采集"的实现


"文章列表"页面: article_list.html

"公众号管理"页面: wechat_list.html

请制定实现如下需求的计划,待我确认后再实施。

如果你有任何需要澄清的问题,可以问我。